



Meisterschaft der Datenflussdiagramme: Ein umfassender Leitfaden zur KI-gestützten Top-Down-Zerlegung mit Visual Paradigm
Einführung
Im Bereich des komplexen Systemdesigns und des Produktmanagements ist eine klare Datenvisualisierung von entscheidender Bedeutung, um die Ausrichtung des Teams und eine erfolgreiche technische Umsetzung sicherzustellen.Datenflussdiagramme (DFDs) dienen als ein Grundbaustein für Systemanalysten und Produktmanager und bieten eine grafische Darstellung davon, wie Daten durch ein Informationssystem fließen. Die manuelle Erstellung detaillierter,mehrschichtiger DFDs ist jedoch oft zeitaufwändig und anfällig für logische Inkonsistenzen auf verschiedenen Hierarchieebenen.
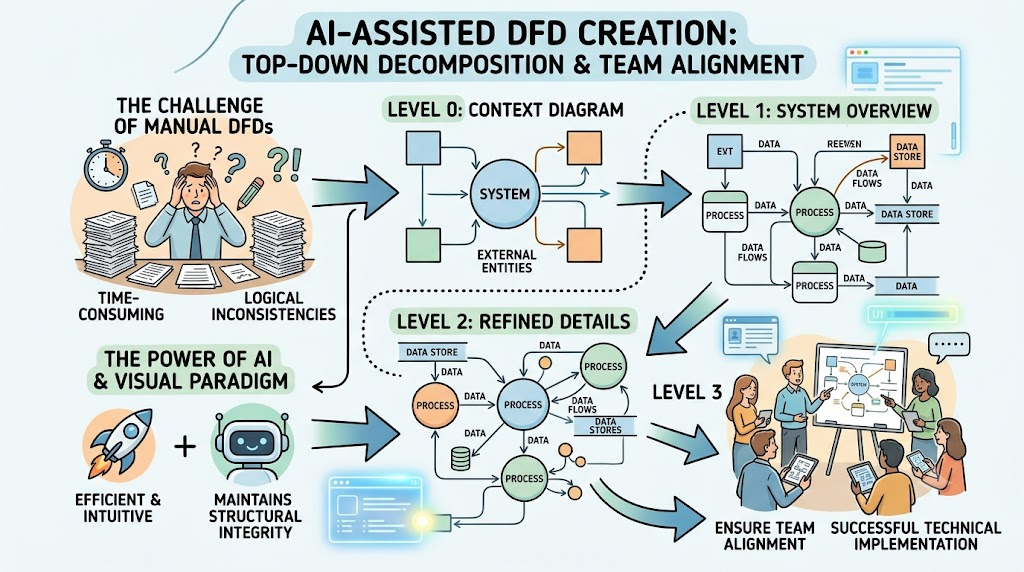
Mit dem Aufkommen von KI-gestützten Modellierungstools wie dem Visual Paradigm (VP) AI-Chatbot ist dieser Prozess deutlich effizienter und intuitiver geworden. Dieser Leitfaden verbindet grundlegende DFD-Theorie mit praktischer Anwendung und bietet eine schrittweise Anleitung zur Nutzung von VP AI zur Erstellung von Datenflussdiagrammen unter Verwendung von Top-Down-Zerlegung. Vom Erstellen initialer Kontextdiagramme bis hin zur Verfeinerung granularer Level-3-Details lernen Sie, wie Sie intelligente Prompts nutzen, um die strukturelle Integrität zu wahren, während Sie komplexe Systemlogik erkunden.
Teil 1: Verständnis von Datenflussdiagrammen (DFD)
Was ist ein Datenflussdiagramm?
Ein Datenflussdiagramm (DFD) stellt grafisch den Datenfluss in einem geschäftlichen Informationssystem dar. Es beschreibt die Prozesse, die an der Übertragung von Daten von Eingabequellen zur Dateispeicherung und Berichterstellung beteiligt sind. DFDs werden in zwei Typen unterteilt:
-
Logisches DFD: Beschreibt den Datenfluss durch ein System zur Ausführung spezifischer Geschäftsfunktionalitäten, unabhängig von der Technologie.
-
Physisches DFD: Beschreibt die tatsächliche Implementierung des logischen Flusses, einschließlich Hardware, Software und manueller Verfahren.
Warum DFDs verwenden?
DFDs visualisieren Funktionen, die Daten erfassen, verarbeiten, speichern und verteilen. Ihre visuelle Natur macht sie zu einem hervorragenden Kommunikationswerkzeug zwischen Benutzern und Systemdesignern. Zu den wichtigsten Vorteilen gehören:
-
Klärung des logischen Informationsflusses des Systems.
-
Festlegung der Anforderungen für die physische Systemkonstruktion.
-
Etablierung von Anforderungen für sowohl manuelle als auch automatisierte Systeme.
-
Bereitstellung einer einfachen Notation, die es ermöglicht, mit einem breiten Überblick zu beginnen und sich in detaillierte Hierarchien zu erweitern.
Die vier Grundsymbole des DFD
Es gibt vier Grundsymbole wird verwendet, um ein DFD zu erstellen:
1. Prozess
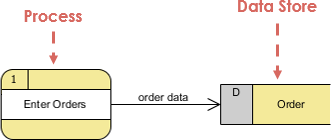
Ein Prozess empfängt Eingabedaten und erzeugt Ausgaben mit anderem Inhalt oder anderer Form. Jeder Prozess muss einen Namen haben, der aus einem Verb gefolgt von einem Singular-Nomen besteht (z. B. Zahlung bearbeiten, Provision berechnen).
-
Notation: Ein abgerundetes Rechteck.
-
Regel: Mindestens ein Datenfluss muss in jeden Prozess eintreten und einer muss ihn verlassen.
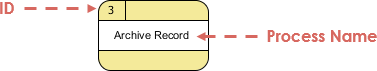
Prozessbeispiel:
2. Datenfluss
Ein Datenfluss ist ein Pfad, über den Daten von einem Teil des Systems zu einem anderen bewegt werden. Er kann ein einzelnes Element (z. B. Kunden-ID) oder eine Struktur (z. B. Bestellinformationen) darstellen.
-
Notation: Gerade Linien mit Pfeilen. Eingehende Pfeile zeigen Eingaben an; ausgehende Pfeile zeigen Ausgaben an.
-
Regel: Alle Flüsse müssen an einem Verarbeitungsschritt beginnen und enden. Daten können sich nicht von selbst transformieren.
Häufige Fehler bei Datenflüssen:
-
Entität zu Entität: Eine Entität kann einer anderen Entität ohne Verarbeitung keine Daten bereitstellen.
-
Entität zu Datenspeicher: Daten können nicht direkt von einer Entität zu einem Datenspeicher bewegt werden, ohne verarbeitet zu werden.
-
Datenspeicher zu Datenspeicher: Daten können nicht direkt zwischen Speichern bewegt werden, ohne verarbeitet zu werden.
| Falsch | Richtig | Beschreibung |
|---|---|---|
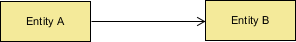 |
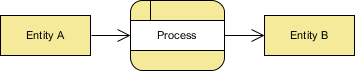 |
Eine Entität kann einer anderen Entität keine Daten bereitstellen, ohne dass eine Verarbeitung stattfindet. |
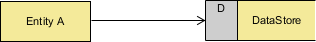 |
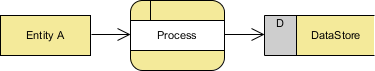 |
Daten können nicht direkt von einer Entität zu einem Datenspeicher übertragen werden, ohne verarbeitet zu werden. |
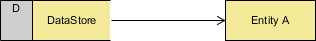 |
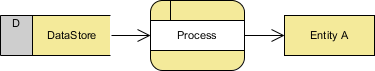 |
Daten können nicht direkt aus einem Datenspeicher entnommen werden, ohne verarbeitet zu werden. |
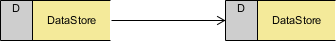 |
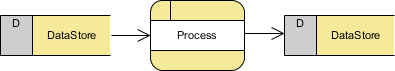 |
Daten können nicht direkt von einem Datenspeicher zu einem anderen übertragen werden, ohne verarbeitet zu werden. |
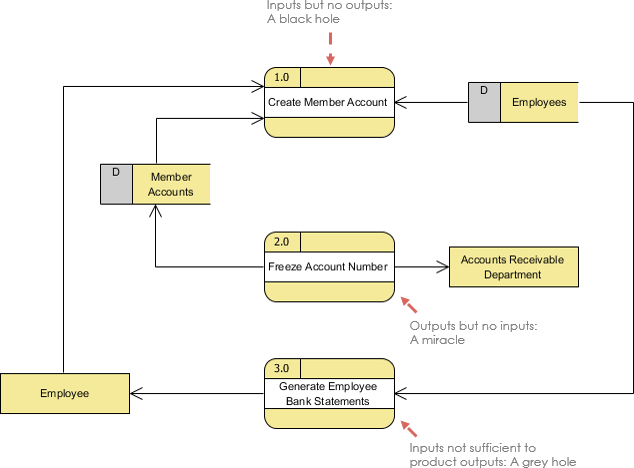
Weitere häufige Fehler:
-
Schwarze Löcher:Ein Prozess mit Eingangsflüssen, aber ohne Ausgangsflüsse.
-
Wunder:Ein Prozess mit Ausgangsflüssen, aber ohne Eingangsflüsse.
-
Graue Löcher:Ein Prozess, bei dem die Ausgaben größer sind als die Summe der Eingaben.
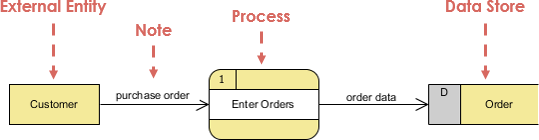
Beispiel für einen Datenfluss:
3. Datenspeicher
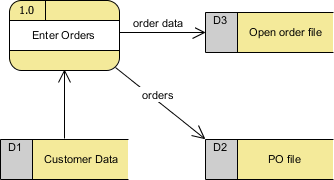
Ein Datenspeicher stellt einen Zustand dar, in dem das System Daten für die spätere Verwendung durch einen oder mehrere Prozesse speichern muss. Beispiele sind Lagerbestand, Forderungen und Bestellungen.
-
Notation:Zwei parallele Linien oder ein Rechteck mit einer offenen Seite (je nach Standard), das in modernen Werkzeugen oft als Datensatzform dargestellt wird.
-
Regel:Muss über einen Datenfluss mit einem Prozess verbunden sein. Muss mindestens einen Eingangs- und einen Ausgangsfluss haben.

Beispiel für einen Datenspeicher:
4. Externe Entität
Eine externe Entität ist eine Person, eine Abteilung oder ein externes System, das dem System Daten bereitstellt oder Daten vom System empfängt. Sie werden auch als Terminatoren bezeichnet.
-
Notation:Ein Rechteck.
-
Regel:Muss über einen Datenfluss mit einem Prozess verbunden sein. Sie verarbeiten die Daten nicht selbst.
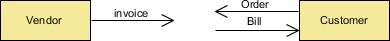
Beispiel für eine externe Entität:
Logische vs. physische Datenflussdiagramme
| Merkmal | Logisches DFD | Physisches DFD |
|---|---|---|
| Fokus | Geschäftsaktivitäten und -funktionen. | Systemimplementierung (Hardware, Software, Personen). |
| Technologie | Unabhängig von der Technologie. | Legt Technologie, Dateien und manuelle Schritte fest. |
| Detaillierung | Geschäftsereignisse auf hoher Ebene. | Detaillierte Schritte, Sequenzierung und temporäre Speicherung. |
| Vorteile | Stabil, einfacher in der Kommunikation mit Benutzern, einfacher zu warten. | Klärt manuelle gegenüber automatisierten Aufgaben, legt Dateinamen fest, fügt Kontrollen hinzu. |
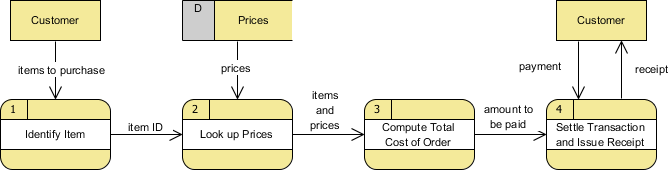
Beispiel für ein logisches DFD – Lebensmittelgeschäft:
Veranschaulicht Prozesse ohne Details zur physischen Implementierung.
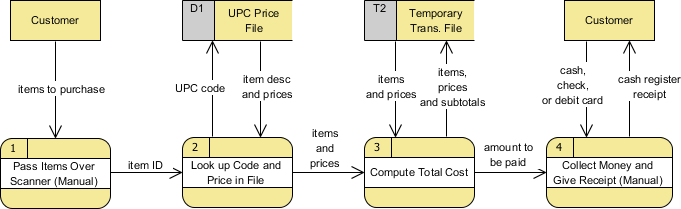
Beispiel für ein physisches DFD – Lebensmittelgeschäft:
Zeigt Barcode-Scanning, manuelle Prozesse, Zahlungsmethoden (Bargeld/Karte) und spezifische Belegnamen.
Richtlinien zur Erstellung von DFDs
-
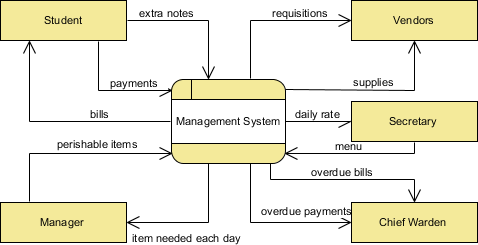
Kontextdiagramm (Ebene 0): Passt auf eine Seite, enthält nur einen Prozess, der das gesamte System darstellt, zeigt alle externen Entitäten und Hauptdatenflüsse, aber keine Datenspeicher.
-
Eindeutige Namen: Verwenden Sie eindeutige Namen für Entitäten und Prozesse innerhalb jeder Ebene.
-
Keine sich kreuzenden Linien: Begrenzen Sie die Anzahl der Prozesse, um sich kreuzende Linien zu vermeiden. Duplizieren Sie bei Bedarf Entitäten/Speicher und markieren Sie diese mit einem Sternchen.
-
Komplexität: Halten Sie Diagramme auf niedrigeren Ebenen auf 7 +/- 2 Symbole (maximal 9 Prozesse) für die menschliche Lesbarkeit.
-
Numerierungskonvention: Verwenden Sie eine hierarchische Numerierung (1, 1.1, 1.1.1).
-
Ausgewogenheit: Eingänge und Ausgänge müssen zwischen Eltern- und Kinddiagrammen erhalten bleiben (Ebene n und Ebene n+1 müssen übereinstimmen).
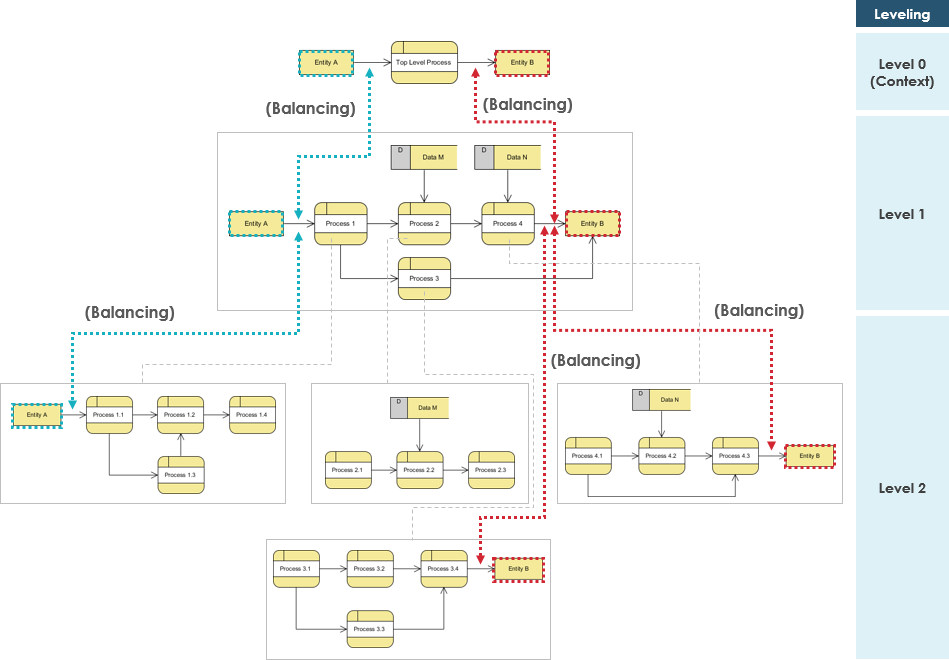
Beispiel für ein Kontext-DFD:
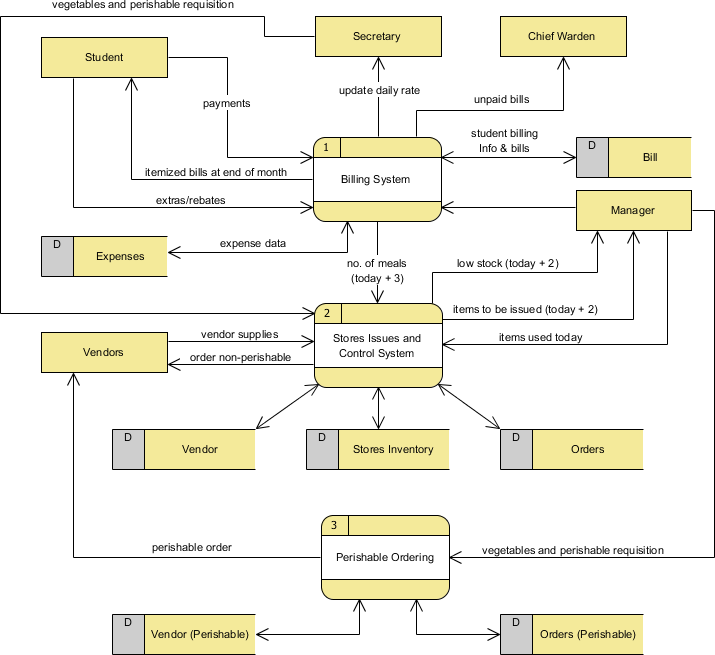
Beispiel für ein Level-1-DFD:
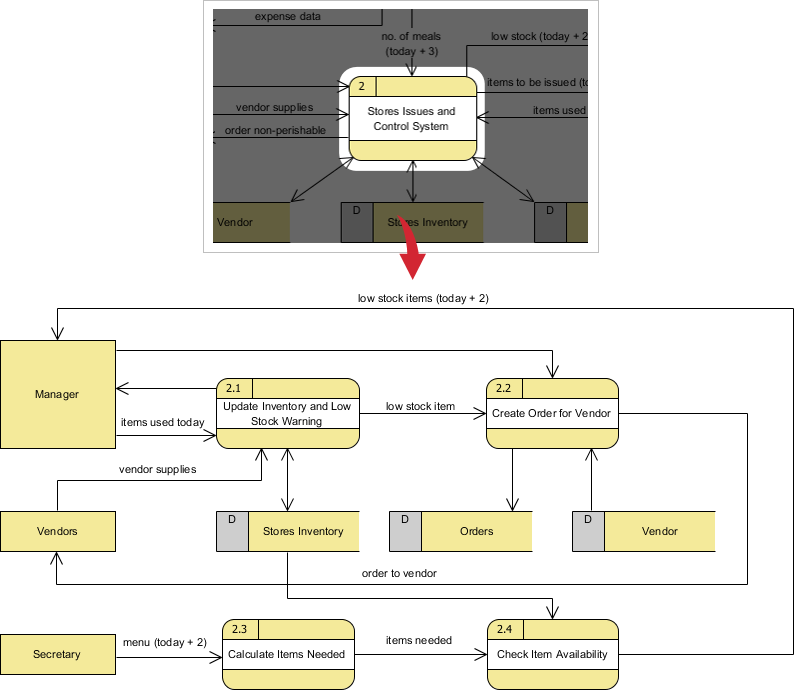
Beispiel für ein Level-2-DFD:
Teil 2: KI-gestütztes DFD-Modellieren mit Visual Paradigm
Während das Verständnis der Theorie entscheidend ist, kann die Anwendung auf komplexe Systeme herausfordernd sein. Das Visual Paradigm (VP) KI-Chatbot vereinfacht diesen Prozess, indem Sie DFDs durch natürliche Sprachbefehle generieren und verfeinern können. Im Folgenden finden Sie eine schrittweise Anleitung unter Verwendung eines Online-Bestellprozessesystems als Fallstudie.
Schritt 1: Zugriff auf den VP KI-Chatbot
-
Öffnen Sie Ihr Projekt in Visual Paradigm.
-
Suchen Sie das KI-Assistenten-Panel.
-
Klicken Sie auf „Chat starten“ um die Sitzung zu starten.
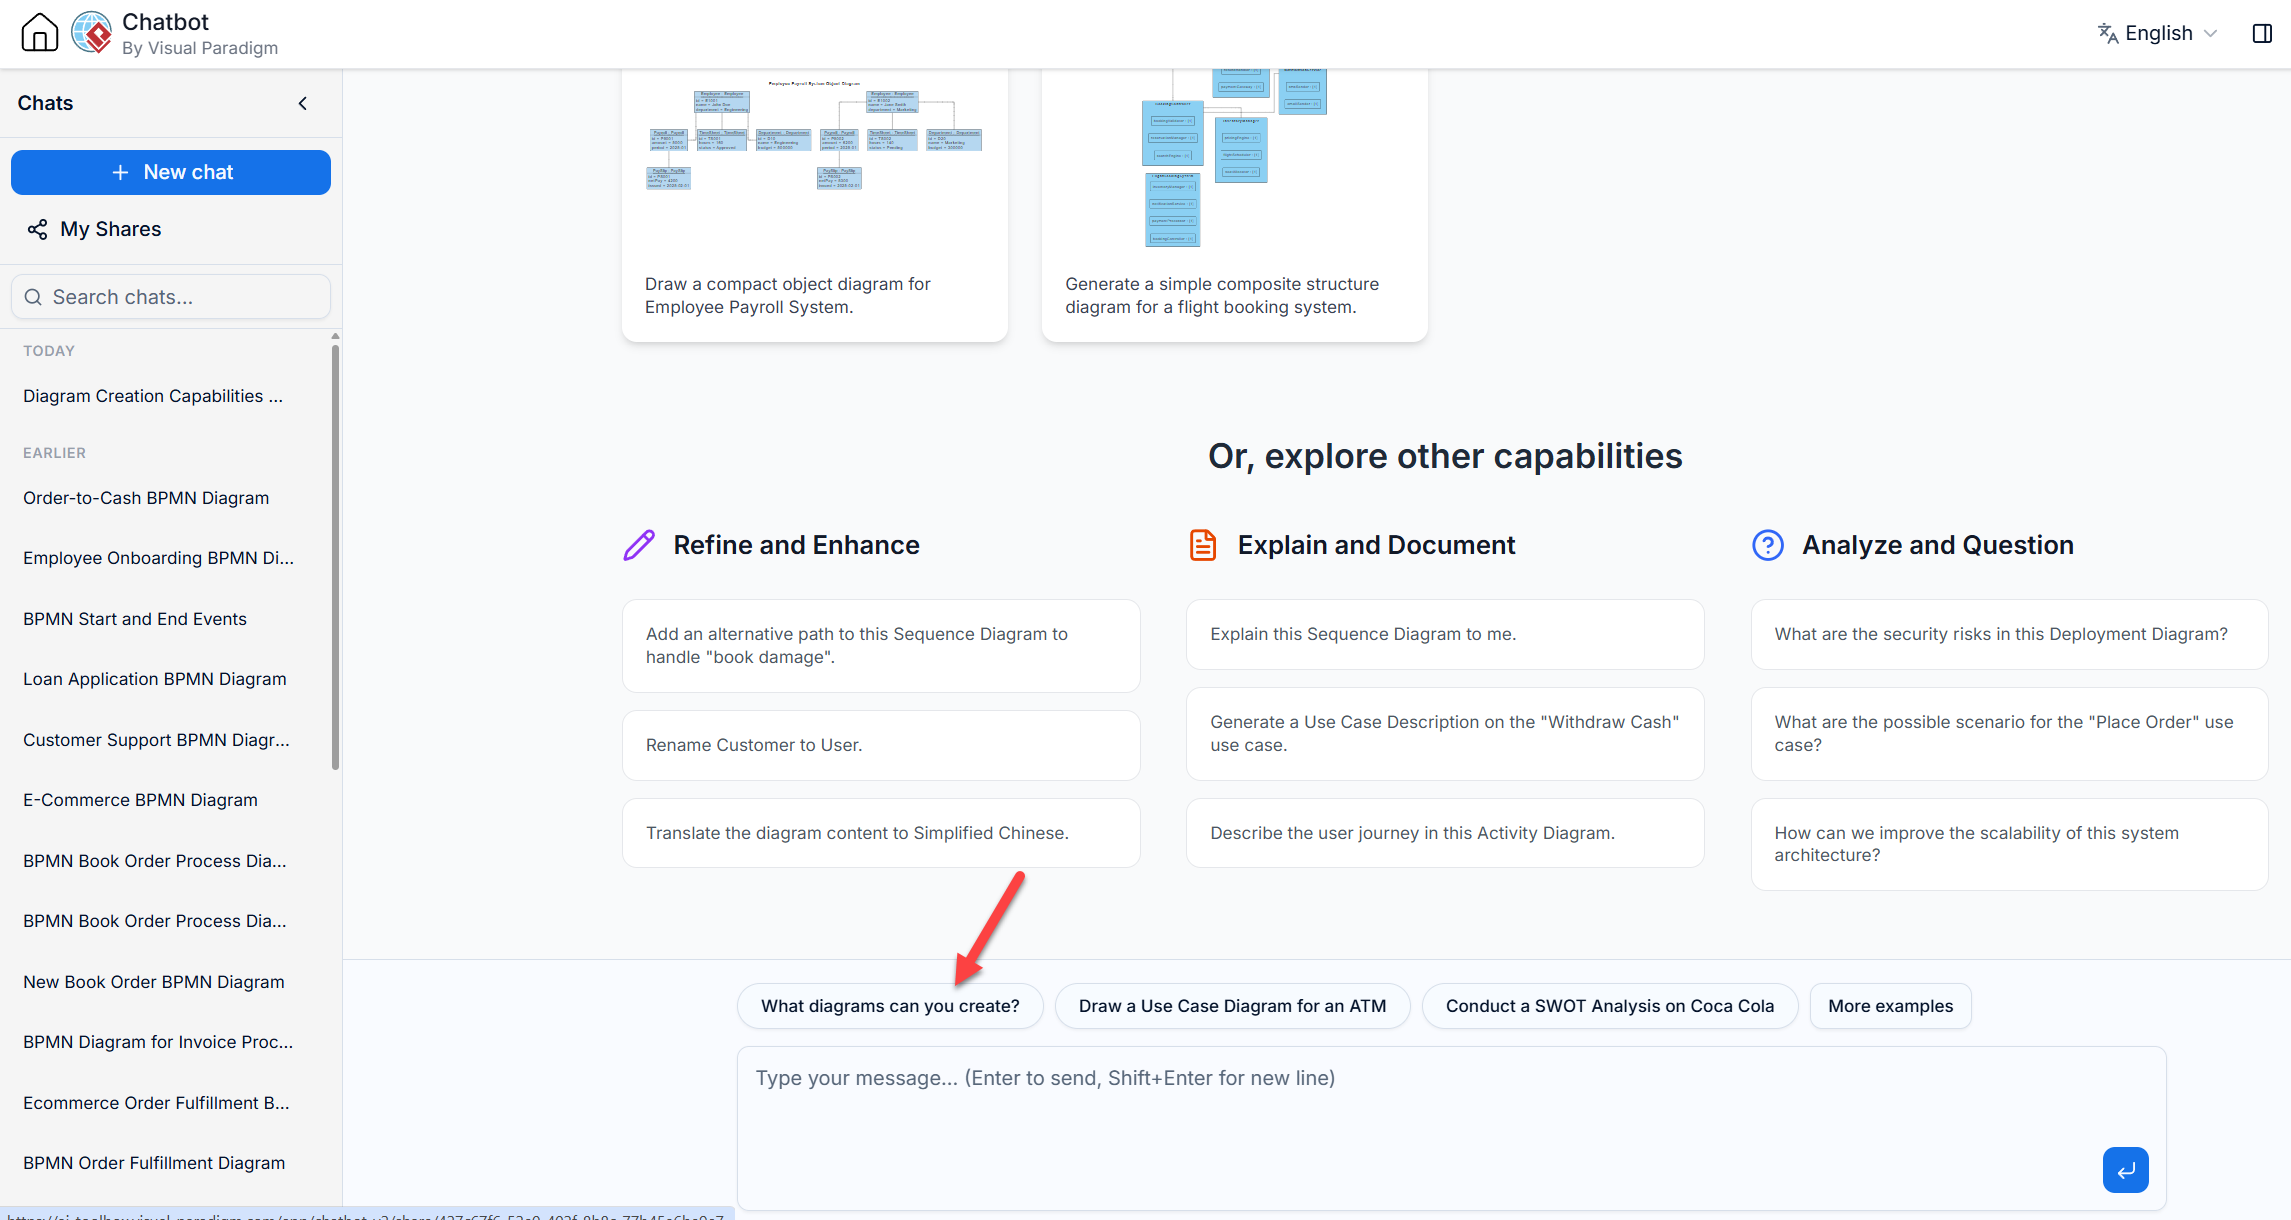
Wenn Sie neu sind, können Sie fragen „Welche Diagramme können Sie erstellen?“ um die unterstützten Typen zu sehen, einschließlich UML, BPMN und DFDs.
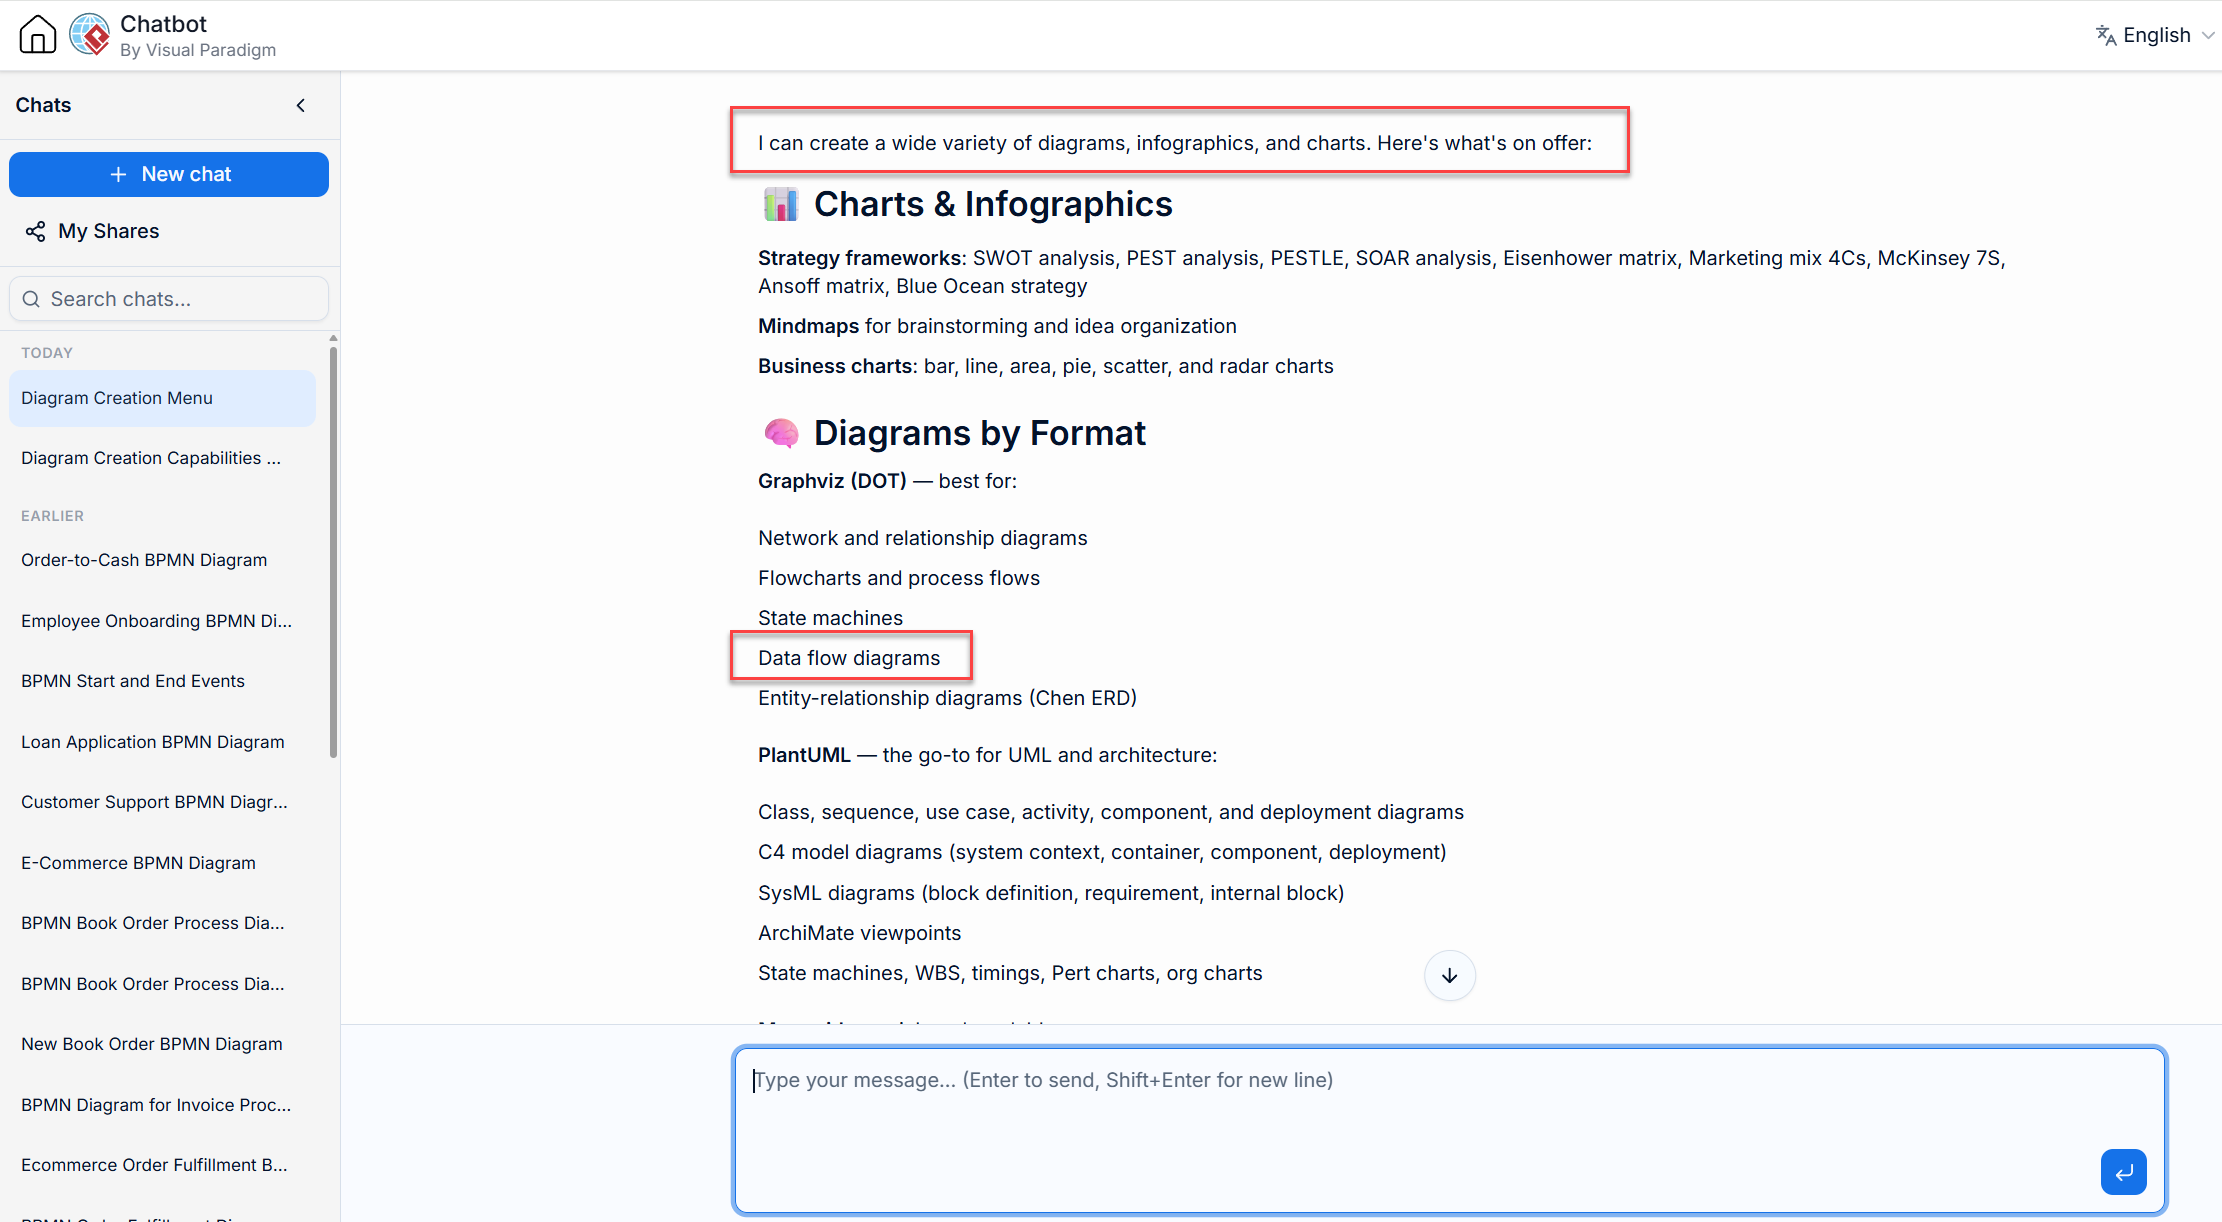
Schritt 2: Erstellen eines Level-1-DFD (Top-Level-Ansicht)
Der erste Schritt bei der Top-Down-Zerlegung besteht darin, die hochstufige Ansicht zu erstellen, externe Entitäten, Hauptprozesse und wichtige Datenspeicher zu definieren.
Eingabeaufforderung:
„Zeichnen Sie ein DFD für ein Online-Bestellprozessesystem“
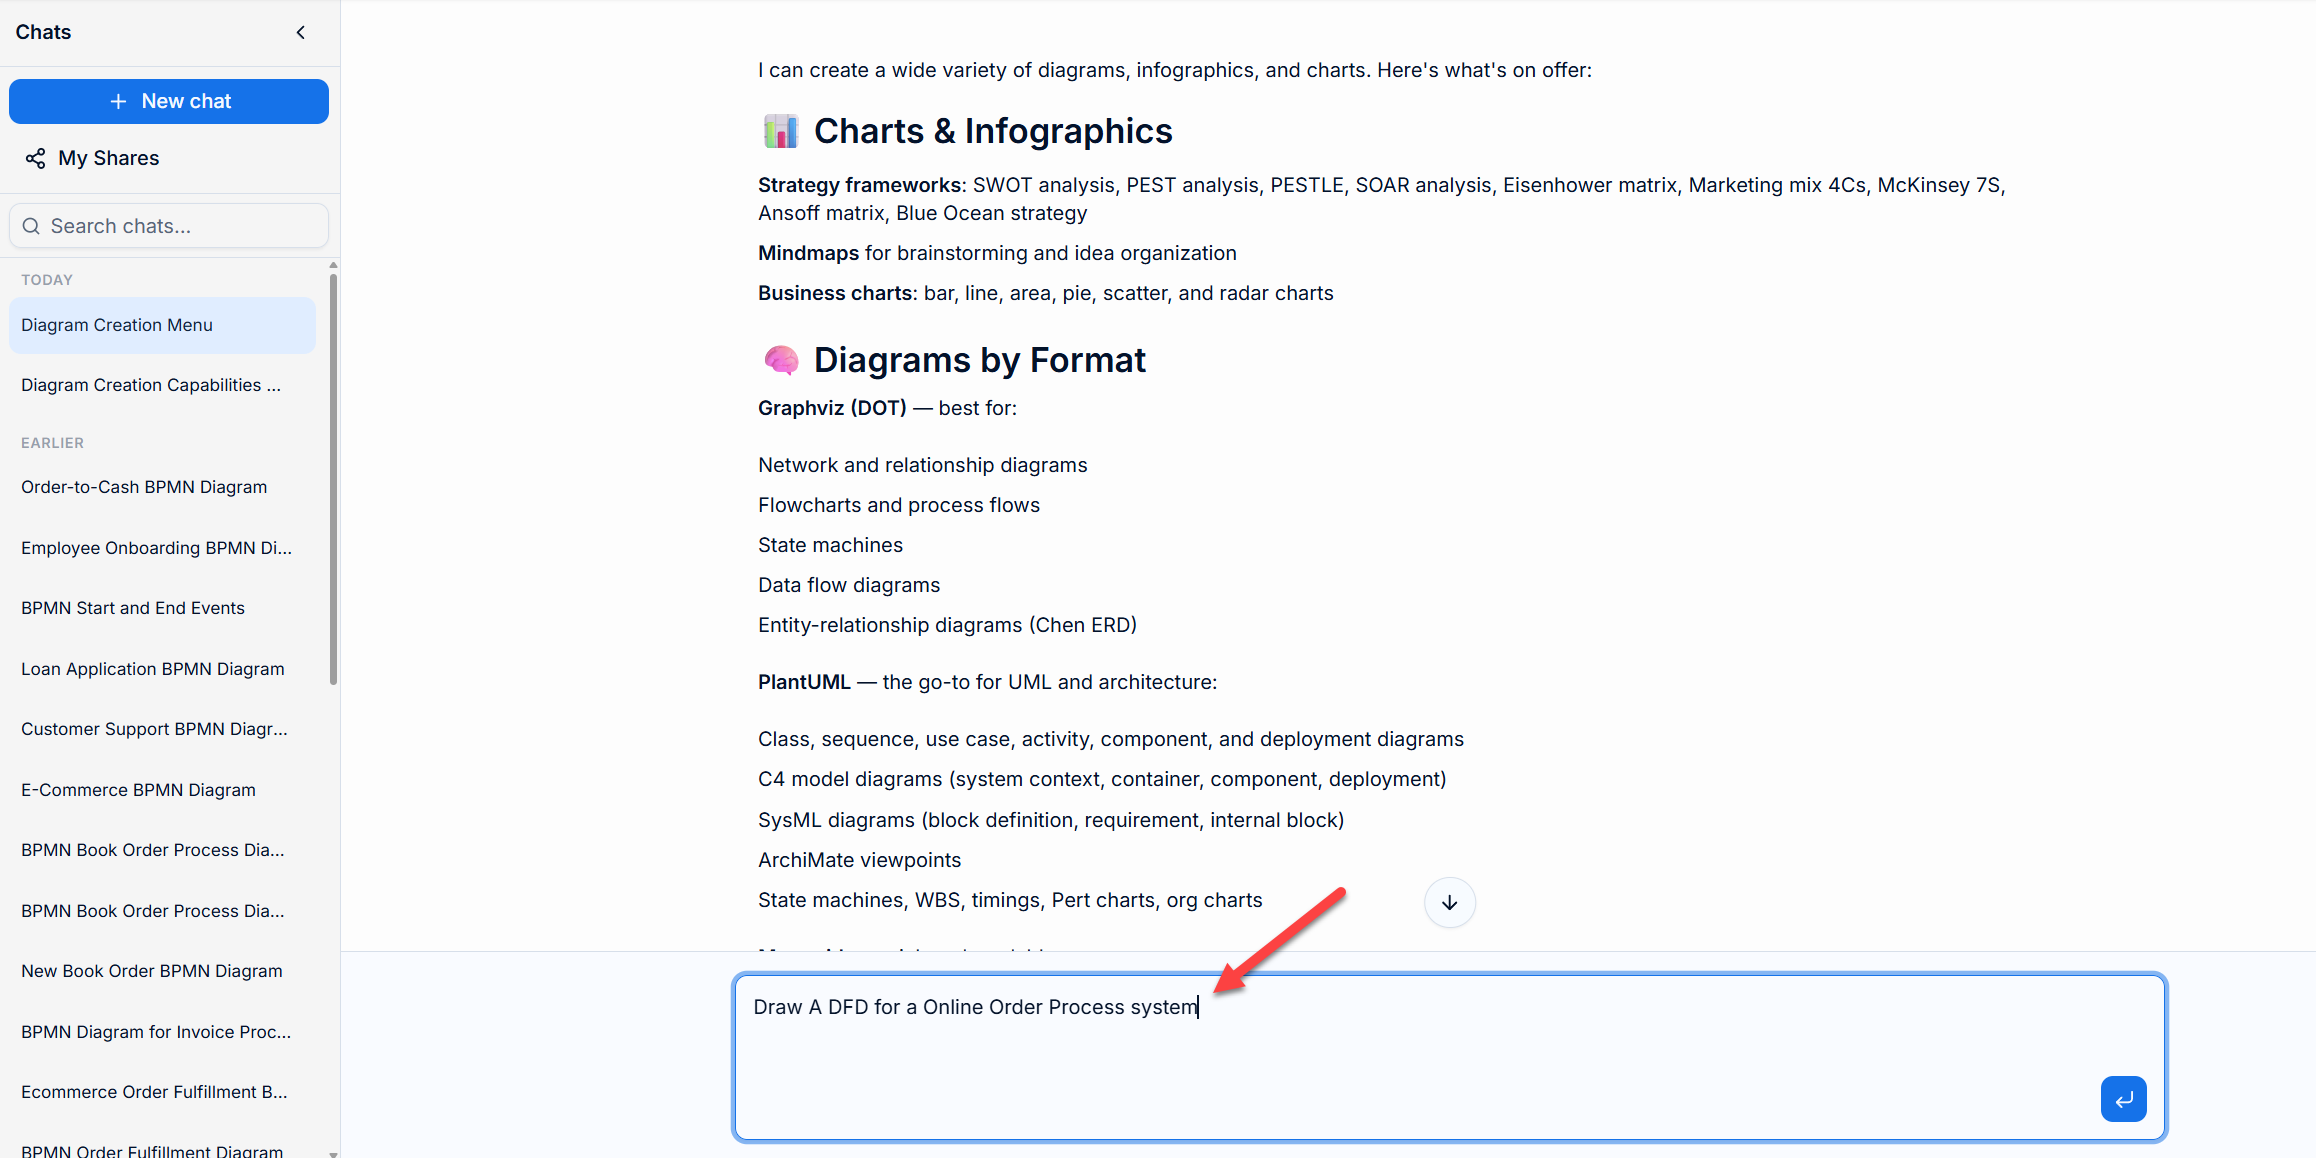
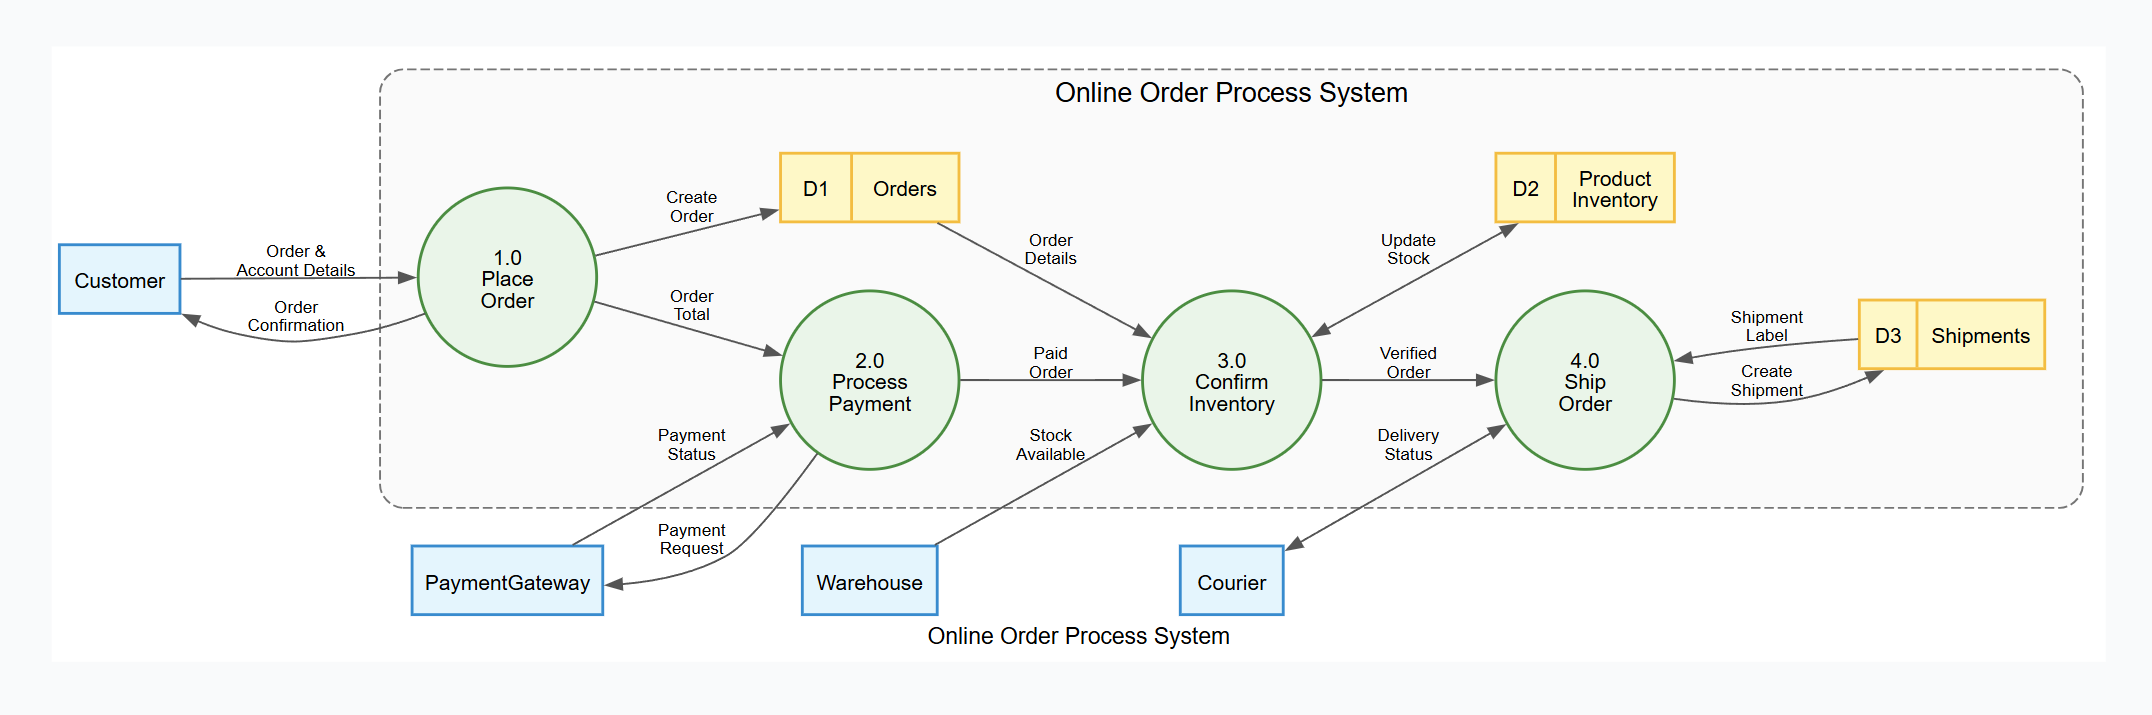
Der VP KI-Chatbot analysiert die Anfrage und generiert ein Level-1-DFD.
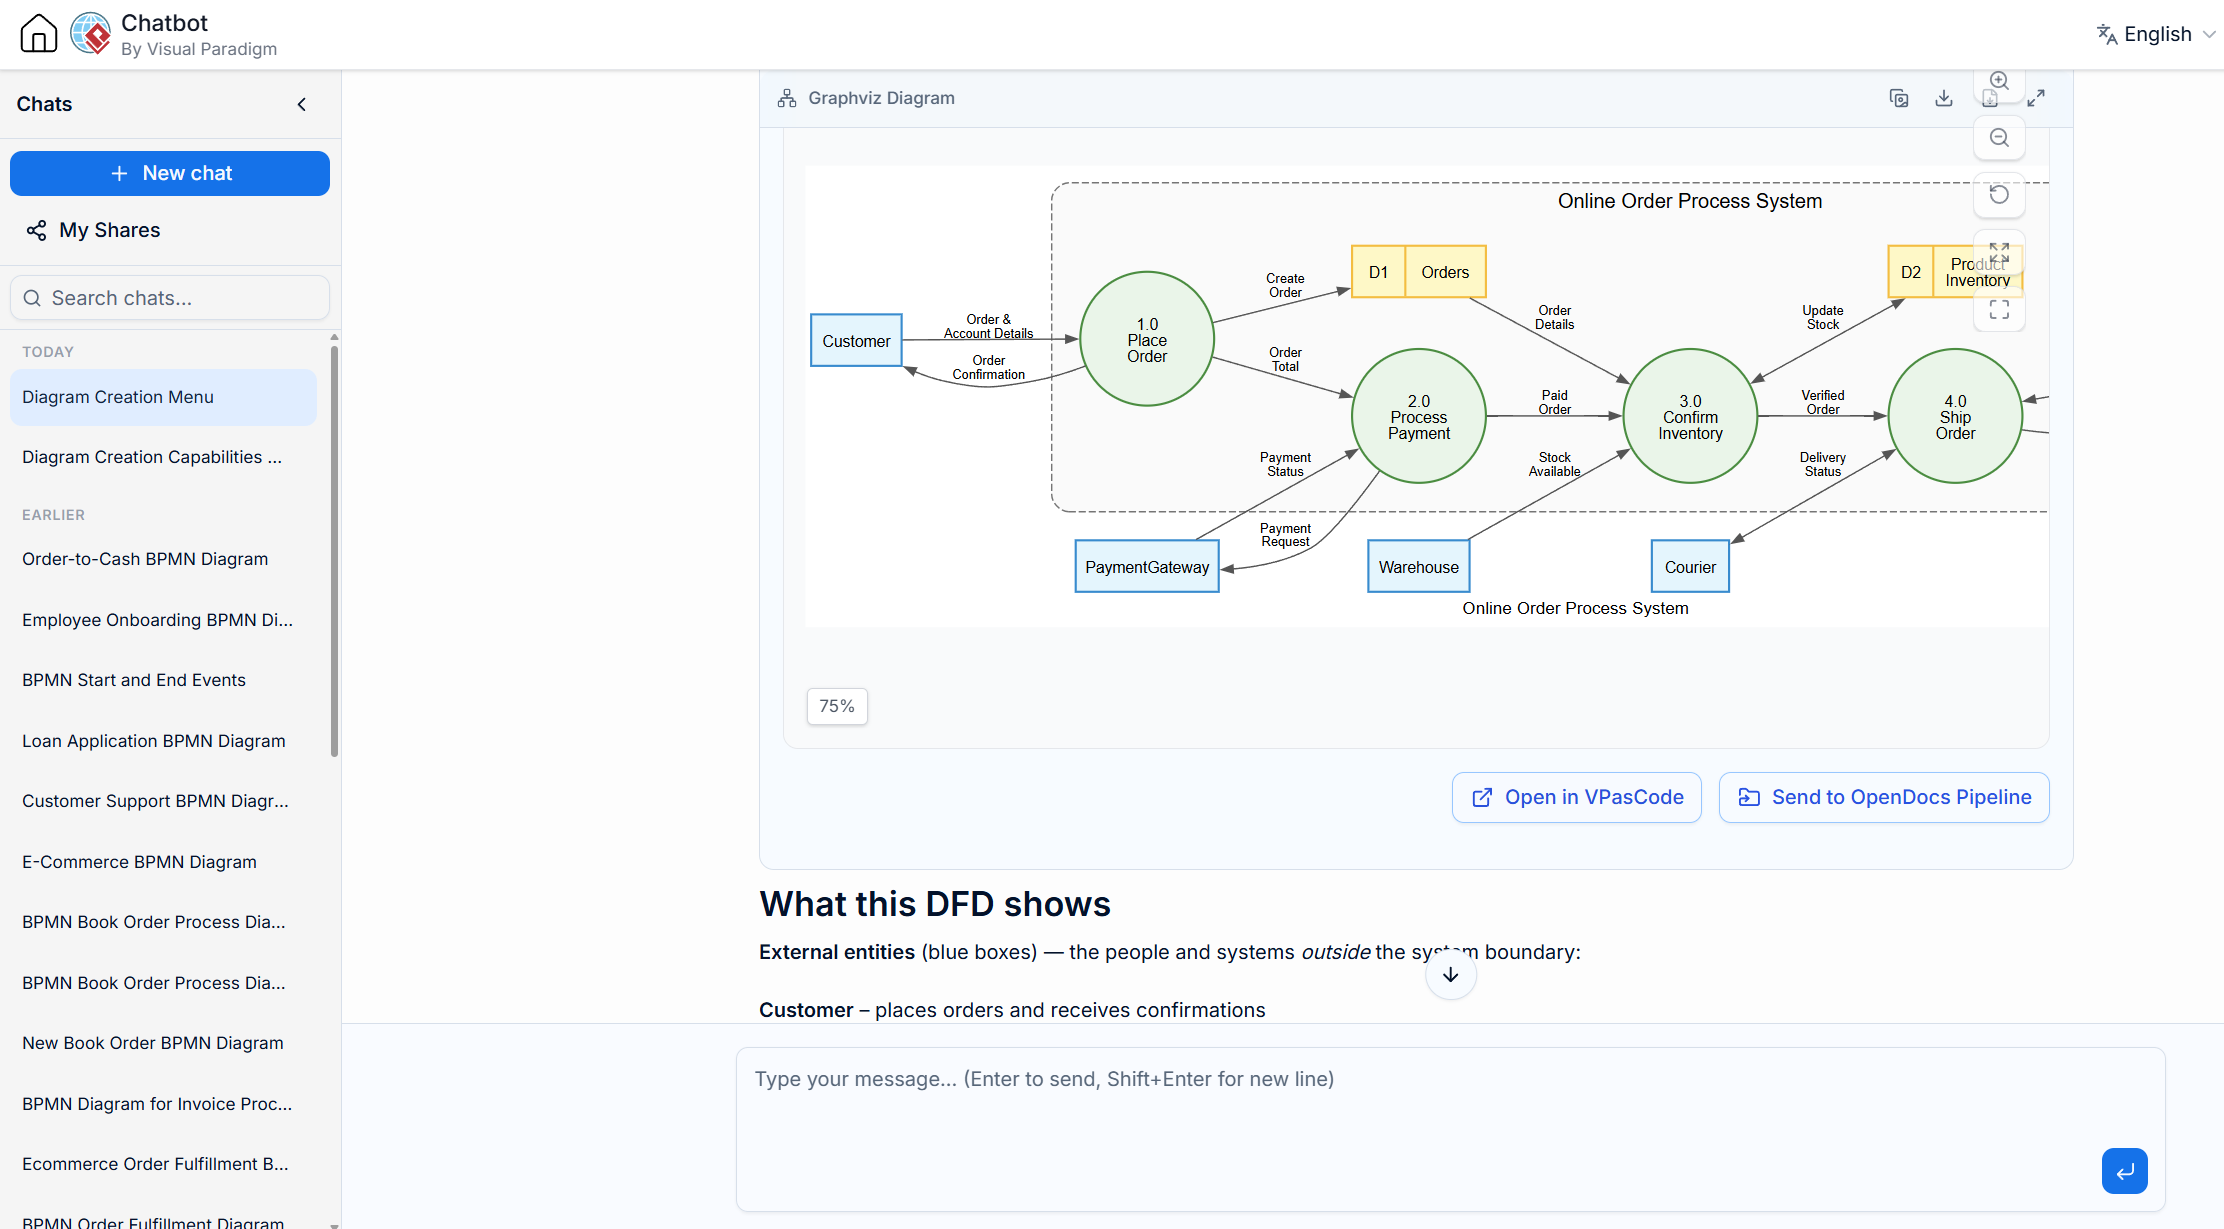
Das generierte Level-1-DFD:
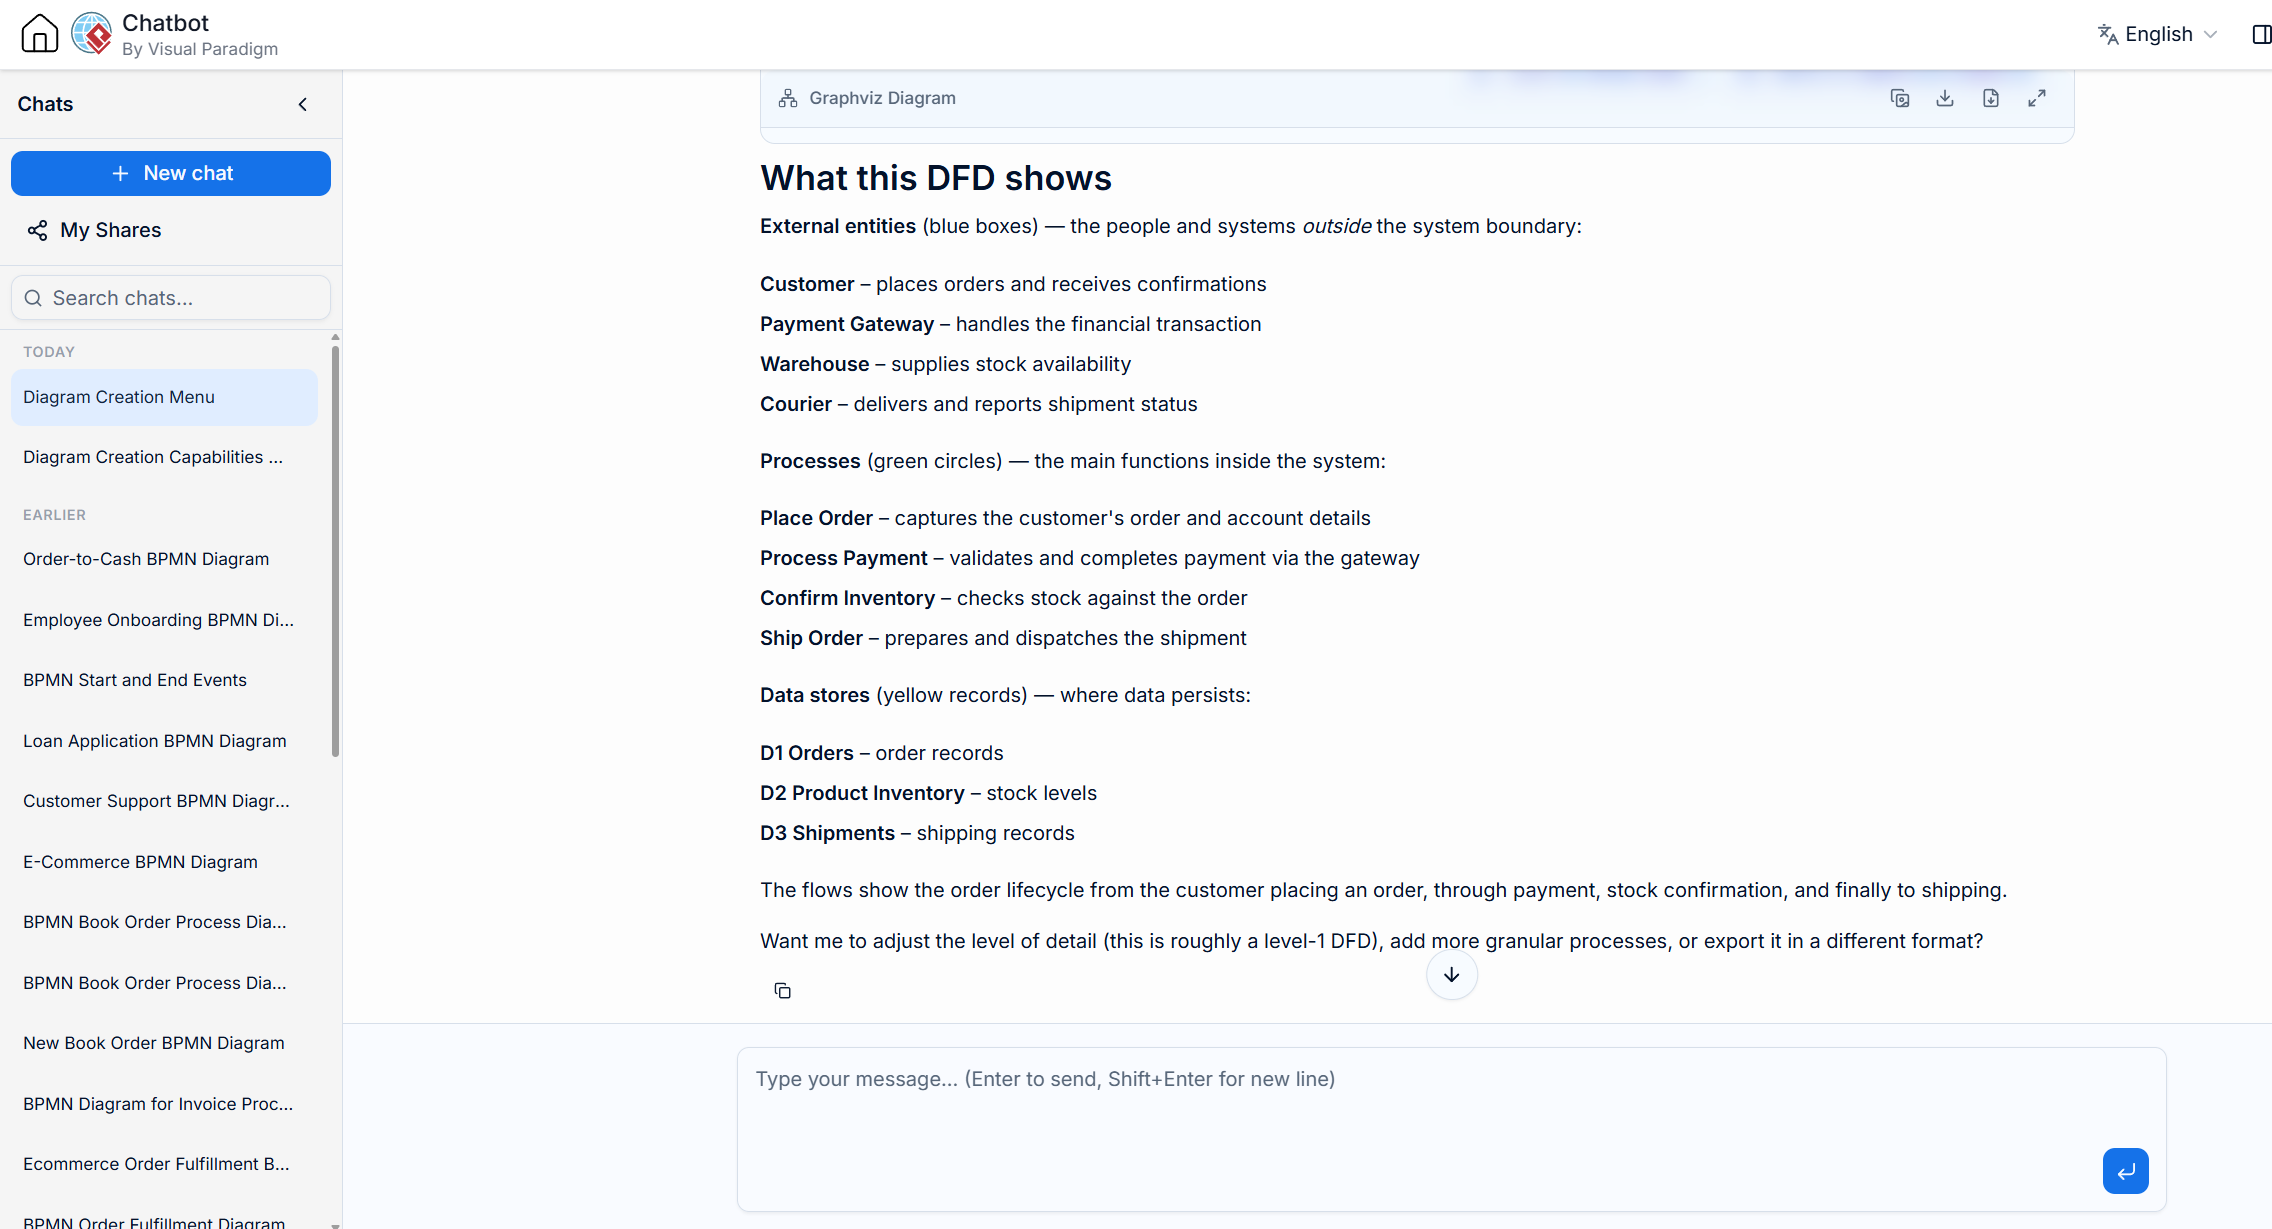
Die KI liefert auch eine textliche Zusammenfassung der Komponenten:
Unter der Haube: Diagramm als Code
Die KI verwendet Graphviz-Dot-Code um das Diagramm darzustellen und dabei Präzision sicherzustellen. Sie können diesen Code im Tab „Code“ einsehen.
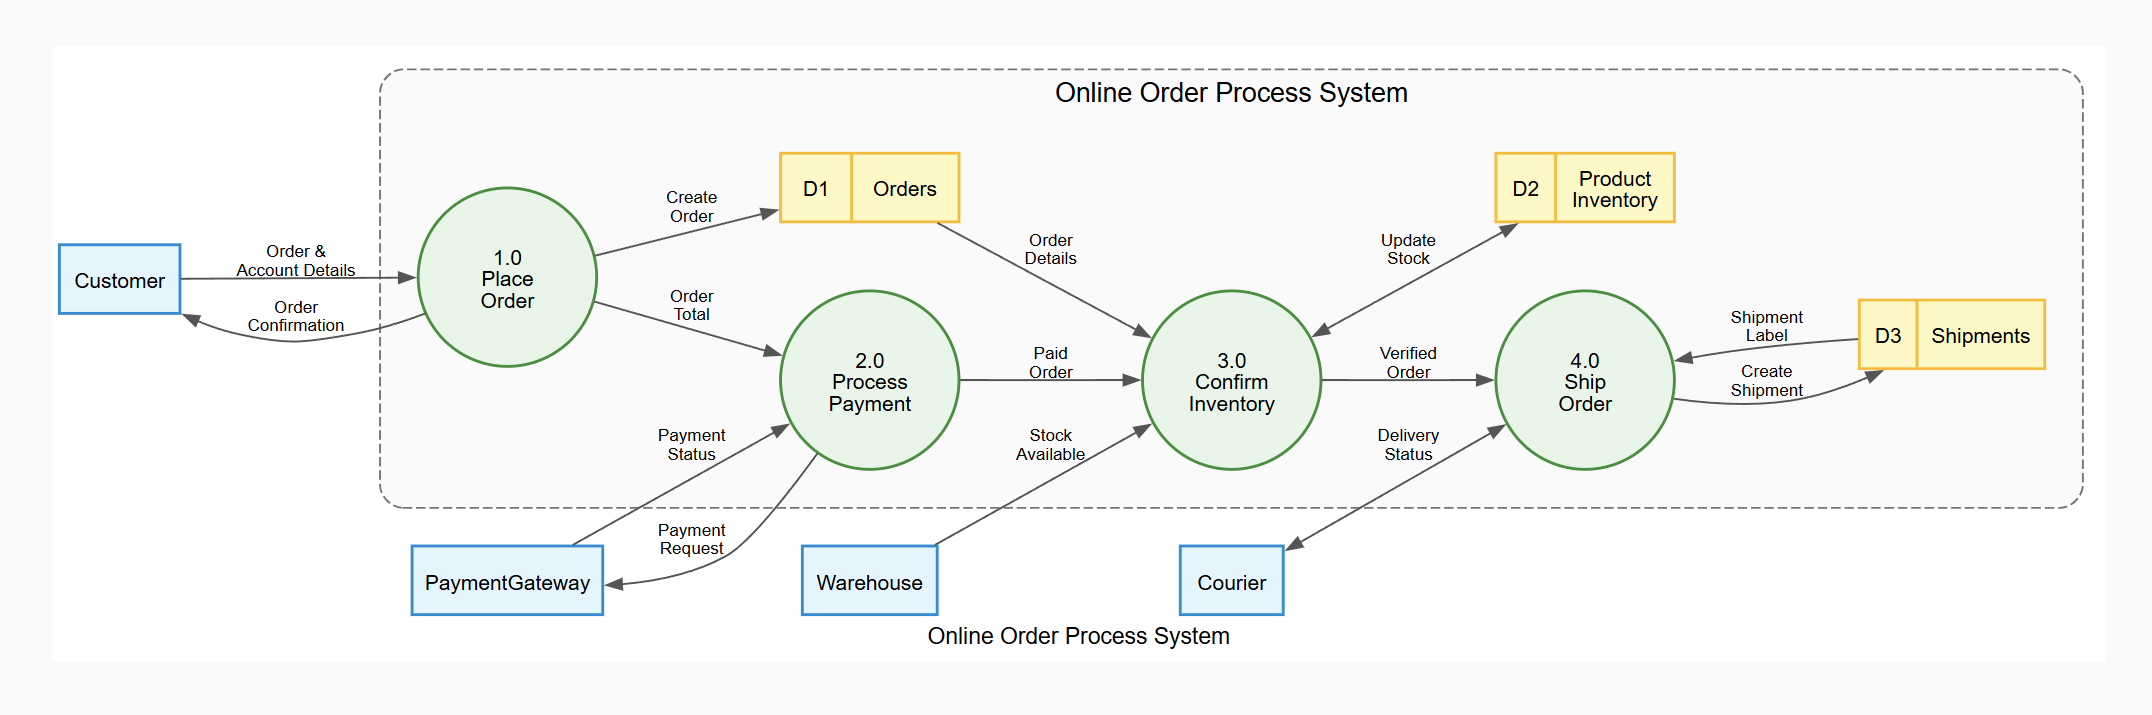
digraph DFD {
    // --- GRAPH STYLE & Diagram Title---
    graph [
        rankdir = LR
        splines = true
        overlap = false
        nodesep = 0.5
        ranksep = 0.8
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 12
        label = "Online-Bestellprozesssystem"
    ]

    // --- NODE STYLES ---
    node [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 11
        penwidth = 1.5
    ]

    // Externe Entitäten
    node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
    Kunde; PaymentGateway; Lager; Kurier;

    // --- SYSTEM GRENZE CONTAINER ---
    subgraph cluster_SystemBoundary {
        label = "Online-Bestellprozesssystem";
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 14
        color = "#757575"
        style = "dashed,rounded"
        bgcolor = "#FAFAFA"
        margin = 20

        // Prozesse
        node [shape = circle, style = "filled", fillcolor = "#E8F5E9", color = "#388E3C", fixedsize = true, width = 1.3]
        P1 [label="1.0nBestellungnAufgeben"];
        P2 [label="2.0nZahlungnVerarbeiten"];
        P3 [label="3.0nLagerbestandnBestätigen"];
        P4 [label="4.0nBestellungnVersenden"];

        // Datenspeicher
        node [shape = record, style = "filled", fillcolor = "#FFF9C4", color = "#FBC02D", fixedsize = false]
        OrderDS [label="{ <id> D1 | Bestellungen }"];
        ProductDS [label="{ <id> D2 | ProduktnLagerbestand }"];
        ShippingDS [label="{ <id> D3 | Sendungen }"];
    }

    // --- KANTEN STYLES ---
    edge [
        fontname = "Helvetica,Arial,sans-serif"
        fontsize = 9
        color = "#555555"
        arrowsize = 0.8
    ]

    // --- DATENFLOWS ---
    // Kundeninteraktionen
    Kunde -> P1 [label="Bestellung &nKontodetails"];
    P1 -> Kunde [label="BestellnBestätigung"];
    P2 -> PaymentGateway [label="Zahlungsnanfrage"];
    PaymentGateway -> P2 [label="Zahlungsnstatus"];

    // Prozess zu Prozess
    P1 -> P2 [label="BestellnGesamtsumme"];
    P2 -> P3 [label="BezahltenBestellung"];
    P3 -> P4 [label="VerifiziertenBestellung"];

    // Prozess zu Datenspeicher
    P1 -> OrderDS [label="Bestellungnerstellen"];                       // schreiben
    P3 -> ProductDS [label="Lagerbestandnaktualisieren", dir=both];           // lesen & schreiben
    P4 -> ShippingDS [label="Sendungnerstellen"];                 // schreiben

    // Datenspeicher zu Prozess
    OrderDS -> P3 [label="Bestellndetails"];                      // lesen
    ShippingDS -> P4 [label="Sendungsnetikett"];                  // lesen

    // Kurier / Lager-Interaktionen
    Lager -> P3 [label="Lagerbestandnverfügbar"];
    Kurier -> P4 [label="Lieferstatus", dir=both];
}
Hauptkomponenten in Ebene 1:
-
Externe Entitäten (blaue Kästen): Kunde, Payment-Gateway, Lager, Kurier.
-
Prozesse (grüne Kreise): 1.0 Bestellung aufgeben, 2.0 Zahlung verarbeiten, 3.0 Lagerbestand bestätigen, 4.0 Bestellung versenden.
-
Datenspeicher (gelbe Datensätze): D1 Bestellungen, D2 Produkt-Lagerbestand, D3 Sendungen.
Schritt 3: Verfeinerung – Zerlegung auf Ebene 2
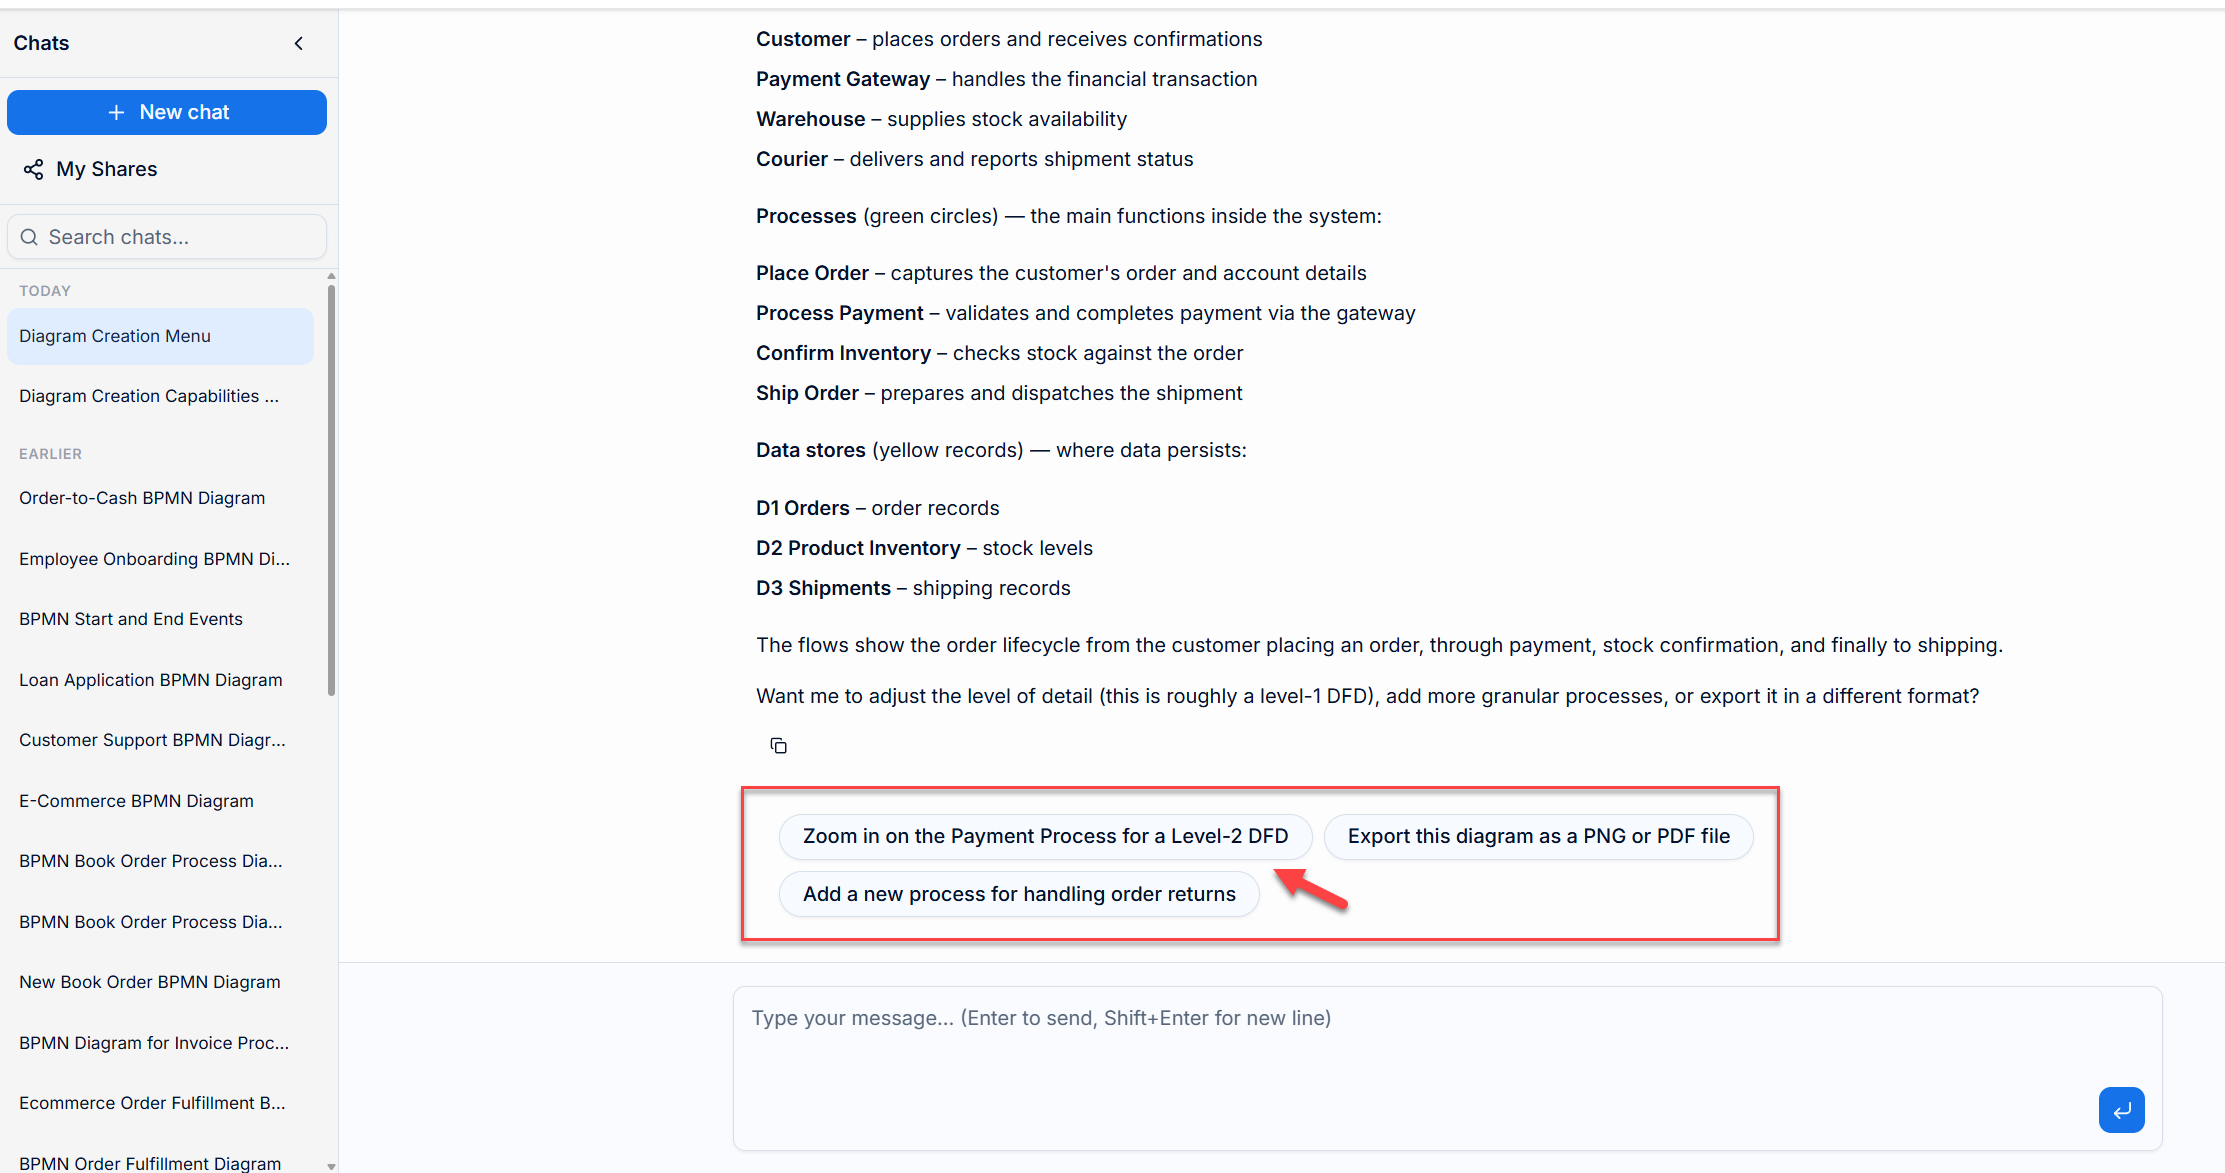
Die Top-Down-Zerlegung erfordert das Aufteilen komplexer Prozesse in kleinere Teilprozesse. Der VP AI-Chatbot unterstützt dies durch intelligente Nachfragen.
Aktion:
Wählen Sie den Vorschlag: „Auf den Zahlungsprozess für ein DFD der Ebene 2 zoomen“
Ergebnis:
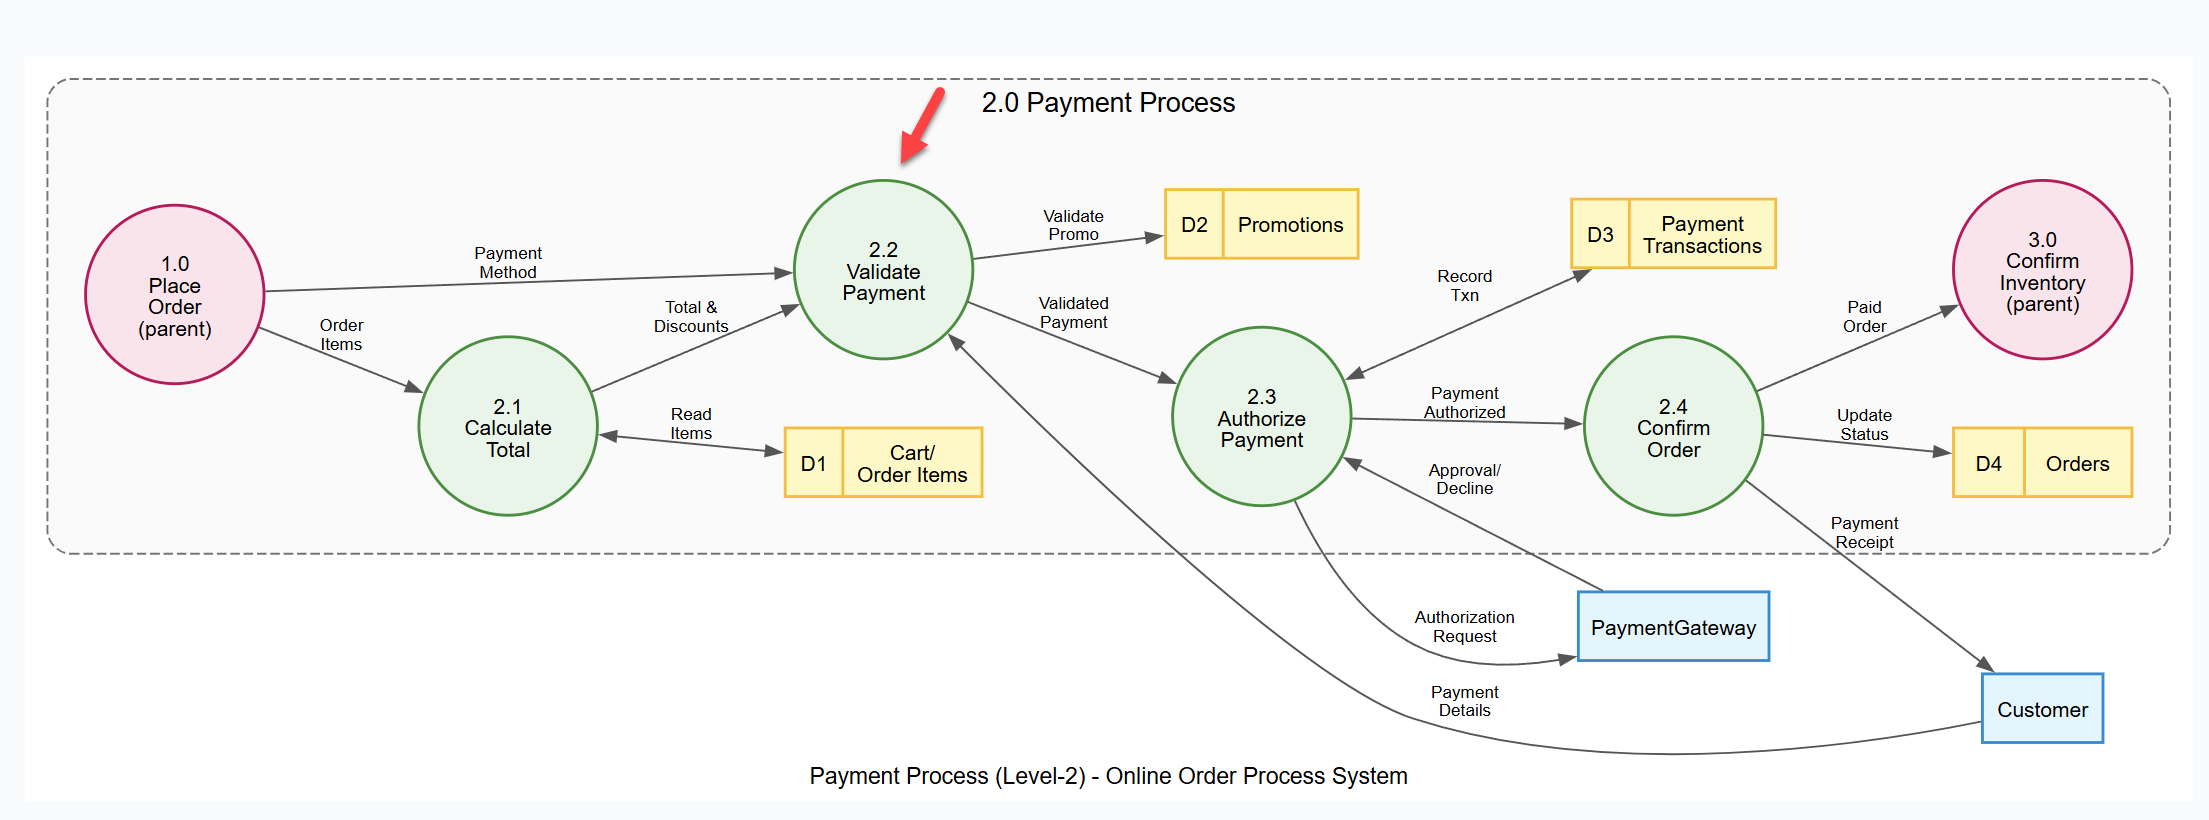
Die KI generiert ein neues Diagramm speziell für Prozess 2.0: Zahlungsprozess.
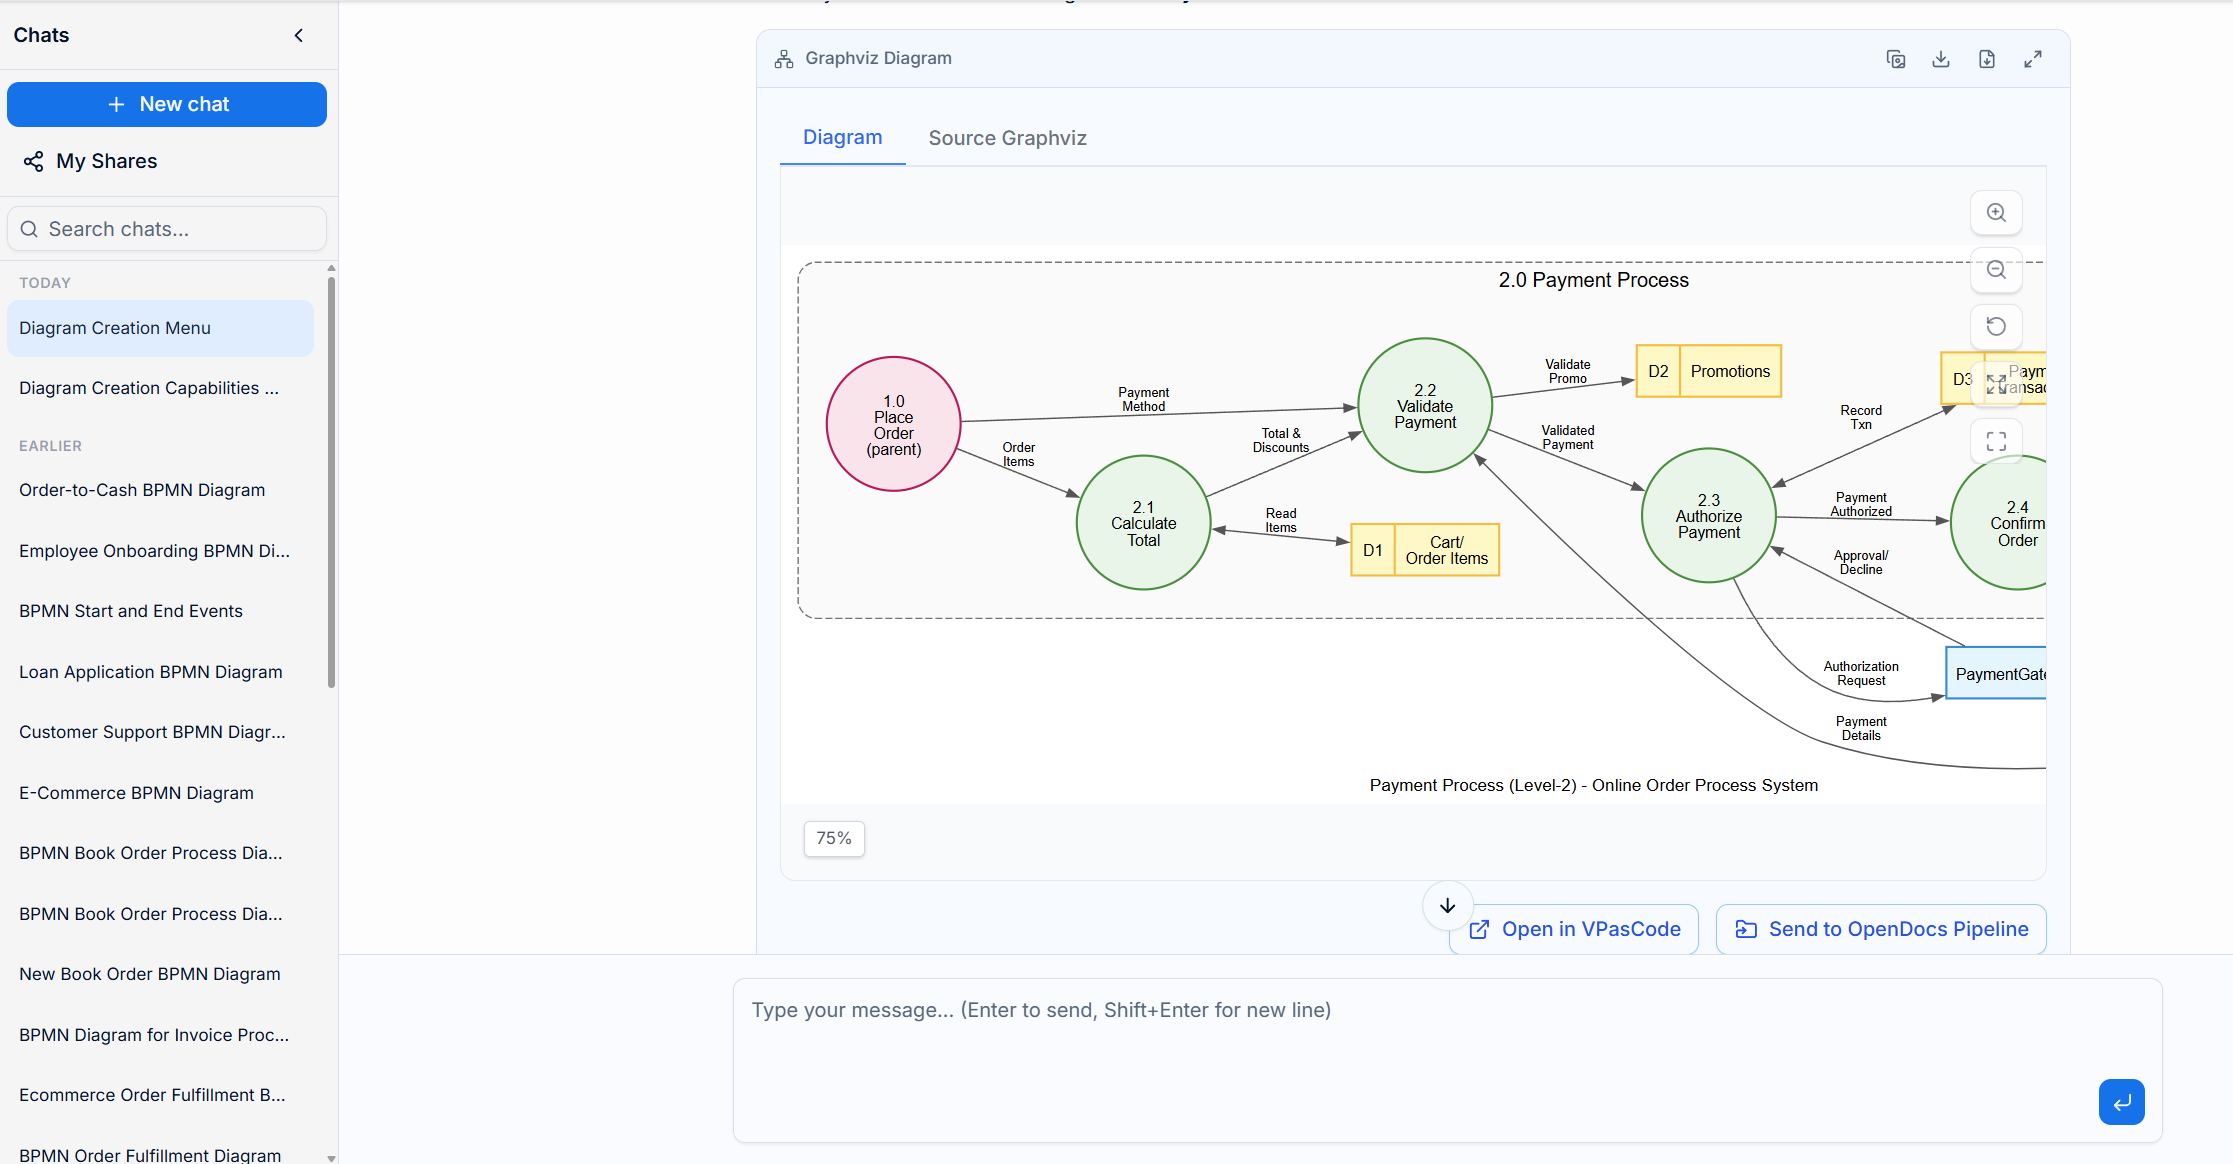
Was ist neu in Ebene 2?
Prozess 2.0 wird in vier Teilprozesse zerlegt:
-
2.1 Gesamtbetrag berechnen: Liest Warenkorbelemente und wendet Promotionen an.
-
2.2 Zahlung validieren: Prüft Zahlungsmethode und Promo-Codes.
-
2.3 Zahlung autorisieren: Kommuniziert mit dem externen Payment-Gateway.
-
2.4 Bestellung bestätigen:Schließt den Status ab und stellt eine Quittung aus.
Wichtige Konventionen:
-
Elternreferenzen:Die Prozesse 1.0 und 3.0 sind in Pink dargestellt als Grenzreferenzen, um den Kontext zu erhalten.
-
Lokale Nummerierung:Datenspeicher werden innerhalb dieses Teildiagramms lokal neu nummeriert (D1–D4).
-
Zweiseitige Flüsse:Dient zur Reduzierung von Unübersichtlichkeit, wenn Daten in beide Richtungen fließen.
Schritt 4: Tiefenanalyse – Zerlegung auf Ebene 3
Für kritische oder komplexe Teilprozesse können Sie tiefer gehen. Lassen Sie uns verfeinern Prozess 2.2: Zahlung validieren.
Aktion:
Wählen Sie den Vorschlag: „Den Teilprozess ‚Zahlung validieren‘ weiter aufschlüsseln“
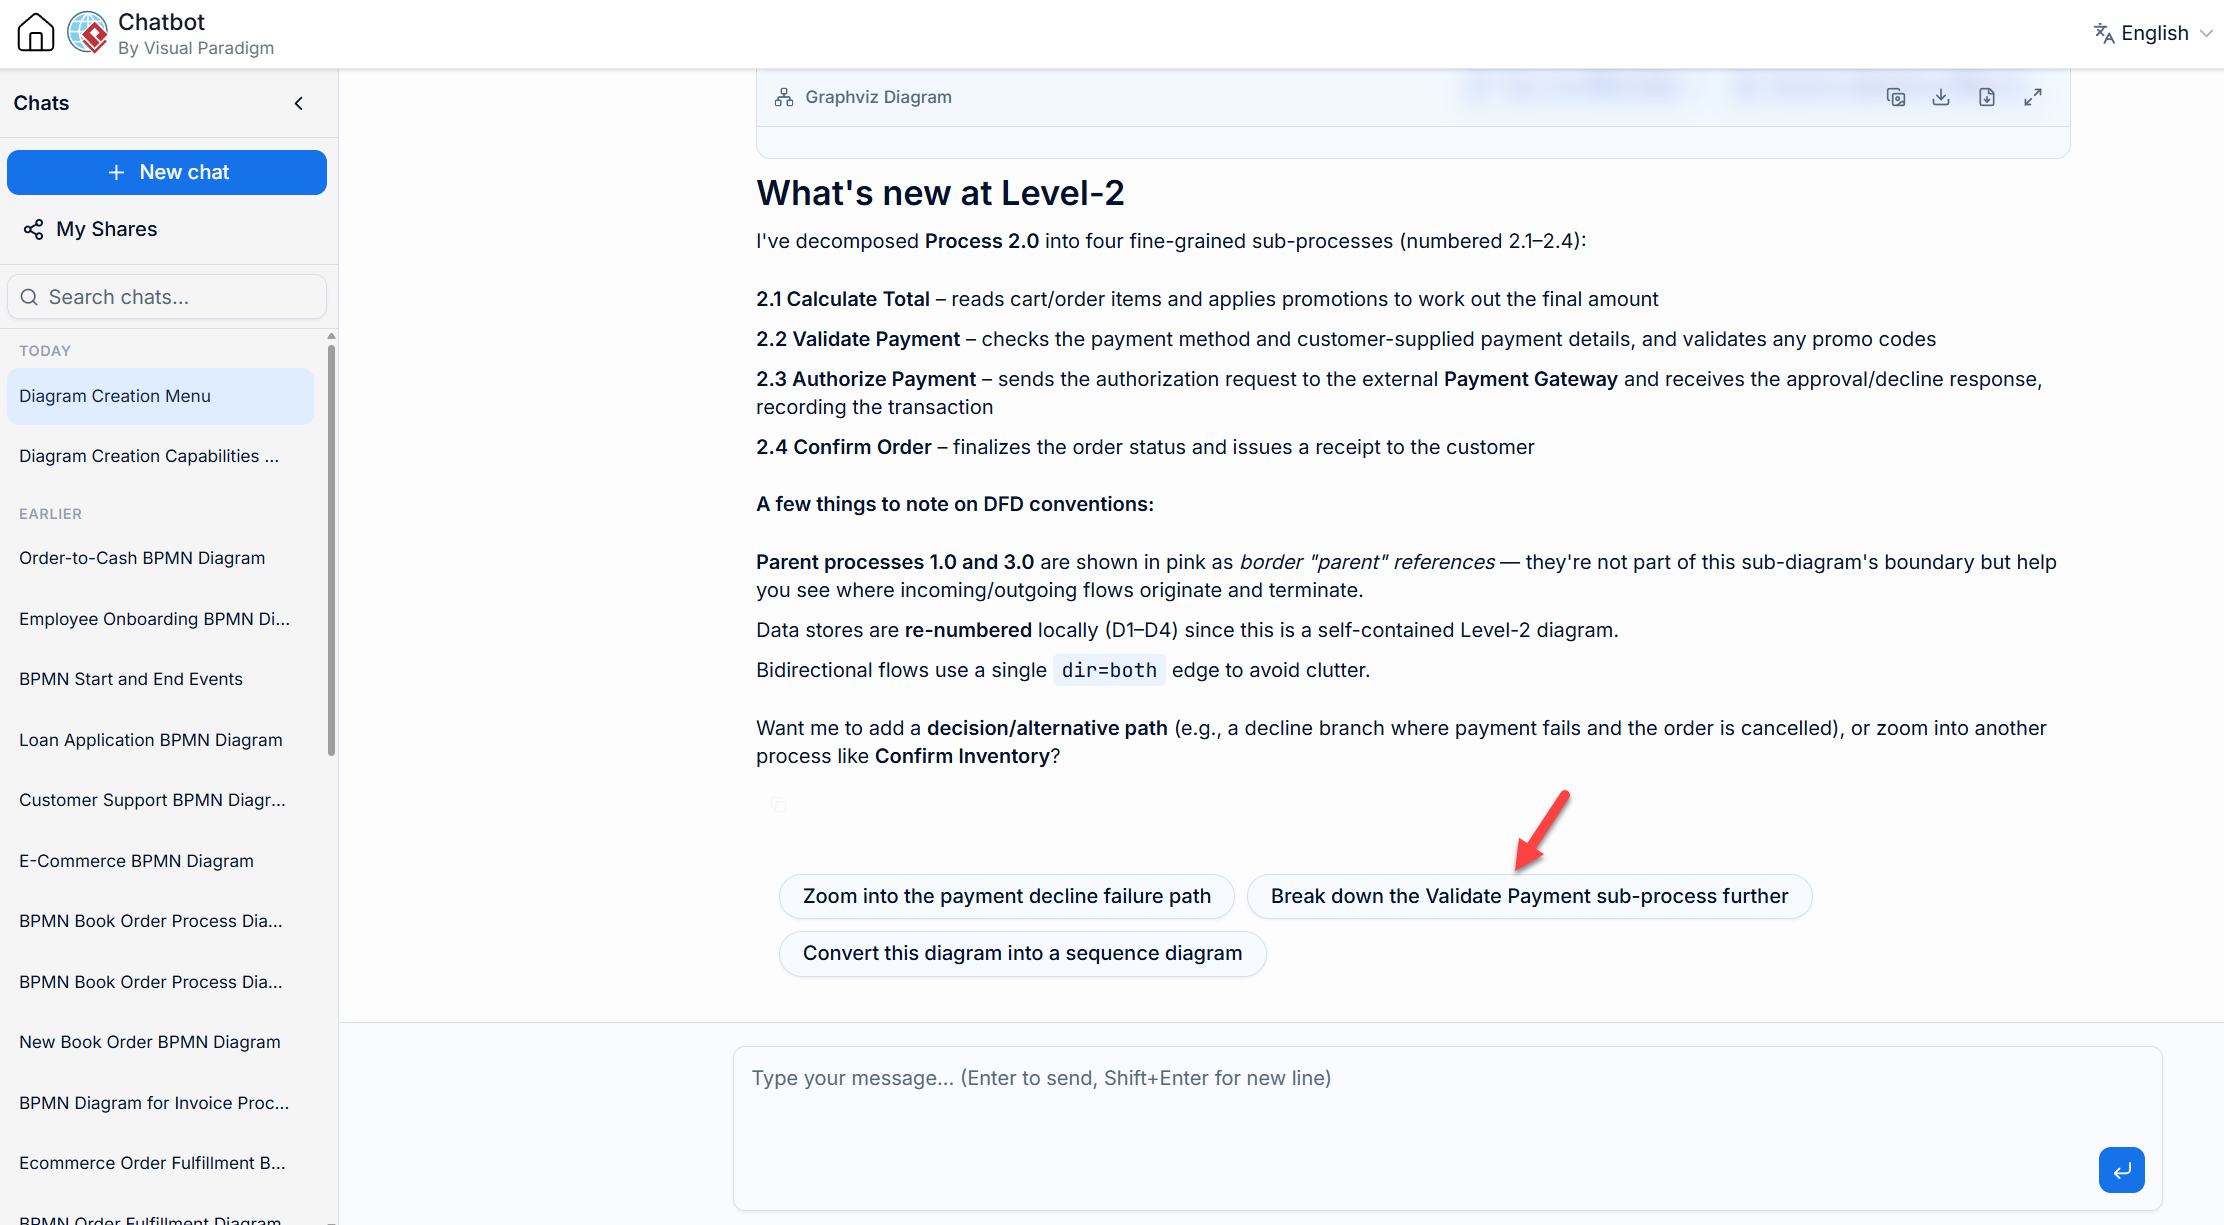
Ergebnis:
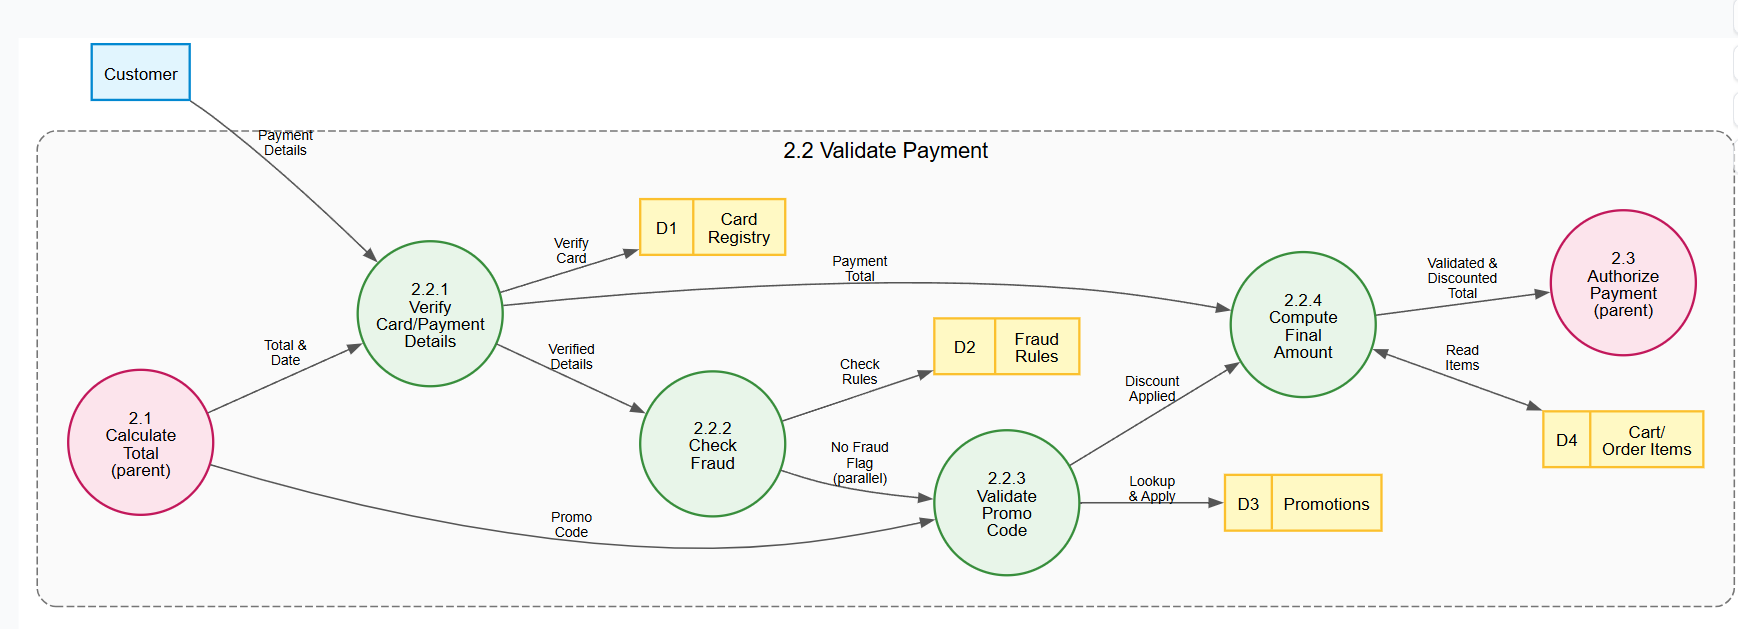
Die KI erstellt einen DFD auf Ebene 3für Prozess 2.2 unter Verwendung einer Nummerierung wie 2.2.1, 2.2.2 usw.
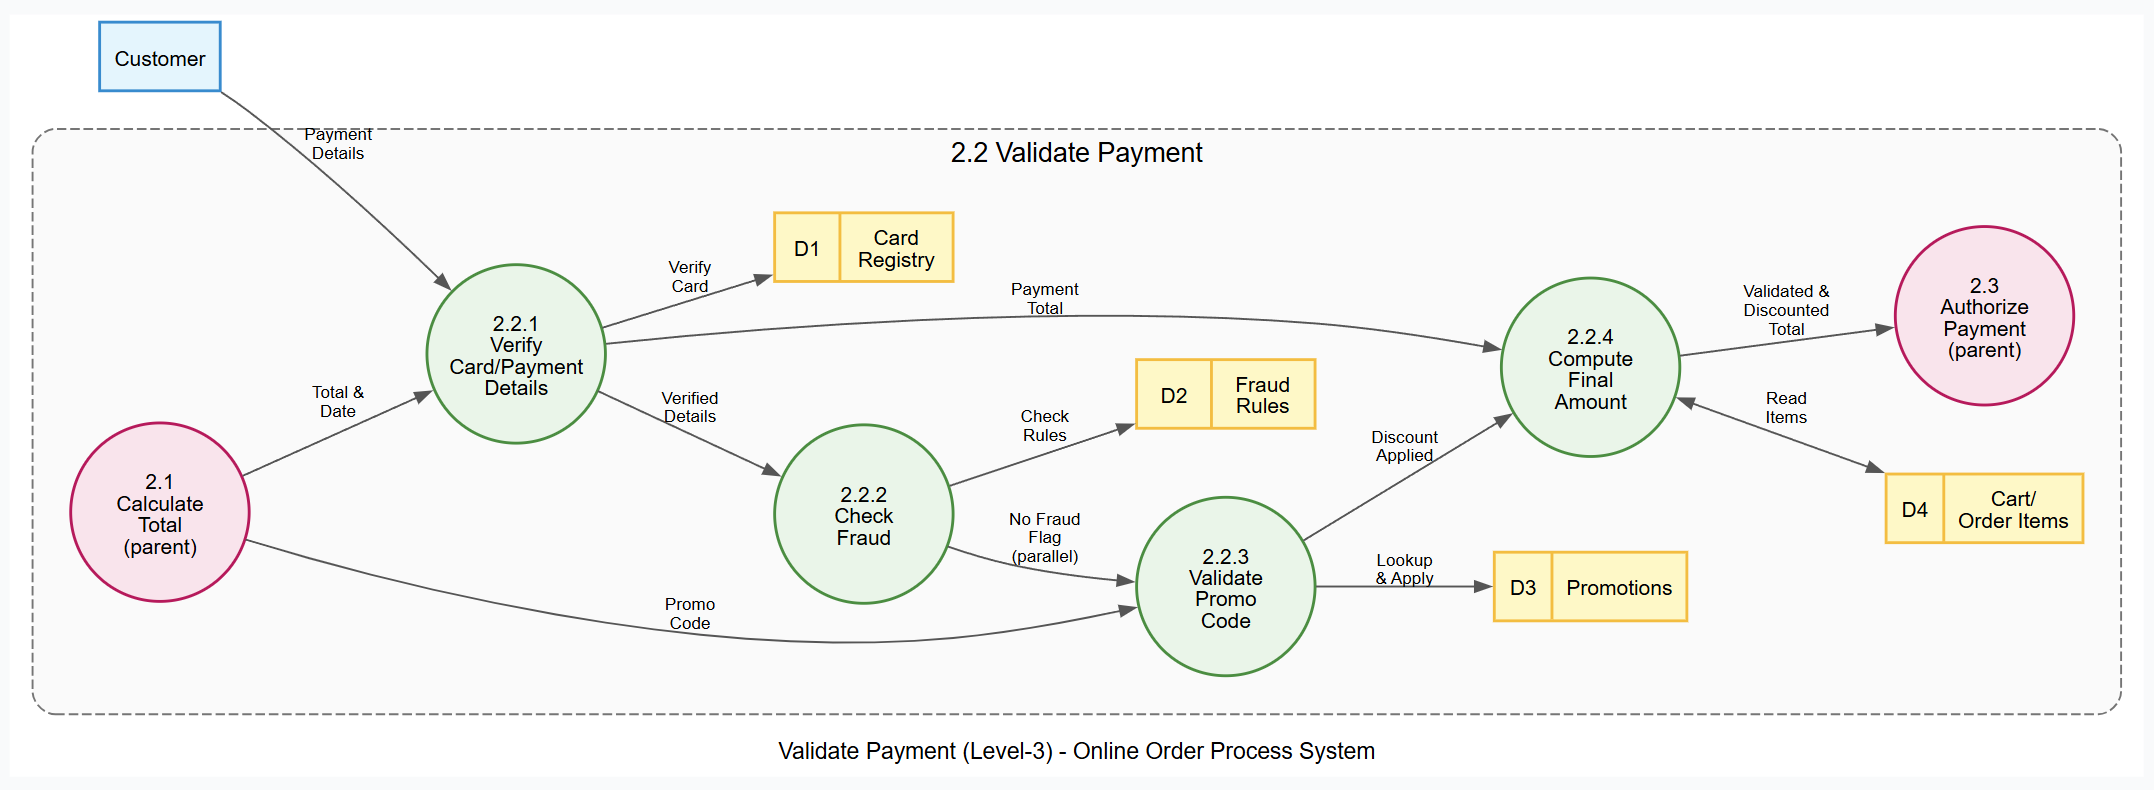
Innerhalb von ‚Zahlung validieren‘ (Ebene 3):
-
2.2.1 Karten-/Zahlungsdetails überprüfen:Überprüft Kartennummer, Ablaufdatum und CVV gegen eine Registrierung.
-
2.2.2 Betrugsprüfung:Prüft die Details gegen Betrugsregeln.
-
2.2.3 Gutscheincode validieren:Sucht Rabatte in einem Gutschein-Speicher ab.
-
2.2.4 Endbetrag berechnen:Kombiniert den Grundbetrag mit Rabatten.
Strukturelle Erkenntnisse:
-
Die Schritte 2.2.2 und 2.2.3 können häufig parallel ausgeführt werden.
-
Die Elternprozesse 2.1 und 2.3 sind in Pink dargestellt, um den Eingabe-/Ausgabe-Kontext zu verdeutlichen.
-
Die Entität Kunde gibt direkt in die Validierungsschritte ein.
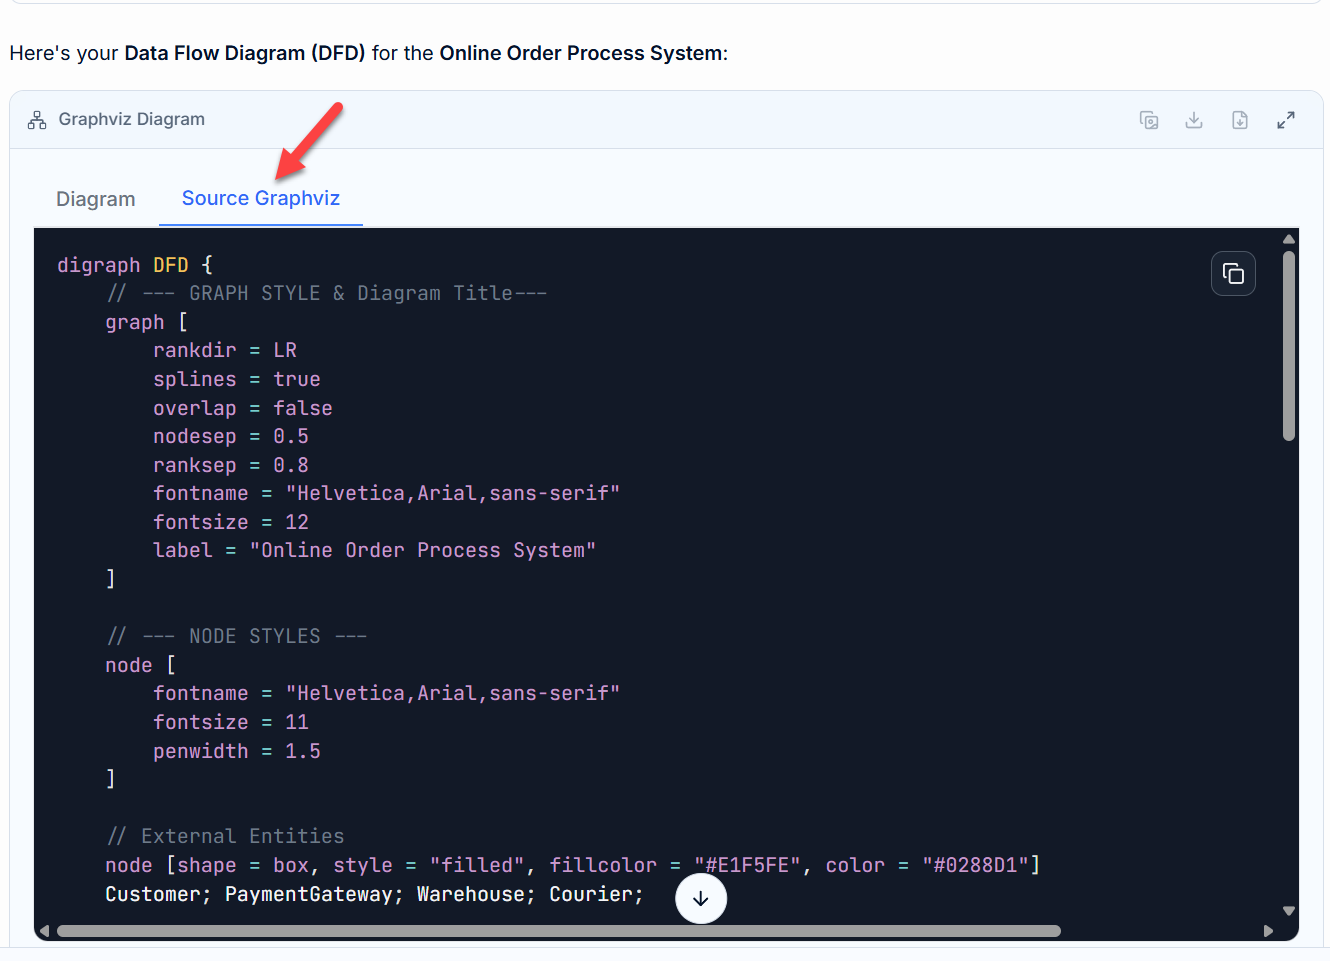
Sie können den entsprechenden Graphviz-Quellcode im Quell-Tab:
Schritt 5: Erweitern des Modells – Fortsetzen und Verzweigen aus gemeinsamen Sitzungen
Eine der leistungsstärksten Funktionen des VP AI-Chatbots liegt in der Fähigkeit, den Kontext über komplexe Modellierungssitzungen hinweg aufrechtzuerhalten. Sie müssen nicht jedes Mal von vorne beginnen. Stattdessen können Sie bestehende Sitzungen fortsetzen oder in parallele Prozesse verzweigen.
Fortsetzen einer gemeinsamen Sitzung:
Um dies in Aktion zu sehen, können Sie auf eine vorbereitete gemeinsame Sitzung zugreifen, die die bisher besprochene Zerlegung enthält (Zahlungsprozess von Ebene 1 zu Ebene 2):
👉 Gemeinsame DFD-Sitzung fortsetzen
Nach dem Laden behält der Chatbot den Kontext des “Online-Bestellprozessesystems” bei. Sie können sofort mit der Definition des nächsten logischen Schritts fortfahren, ohne die ursprüngliche Systembeschreibung erneut einzugeben.
Fokus auf Prozess 3.0:
Angenommen, Sie haben die Zerlegung des Zahlungsprozesses (2.0) abgeschlossen und müssen nun den Lagerbestand bestätigen Prozess (3.0) auf Ebene 2 definieren. Geben Sie dem Chatbot einfach den Auftrag, sich auf die spezifische Prozess-ID aus dem ursprünglichen DFD auf Ebene 1 zu konzentrieren.
Eingabeaufforderung:
“Zoomen Sie auf den Prozess Lagerbestand bestätigen für ein DFD auf Ebene 2”
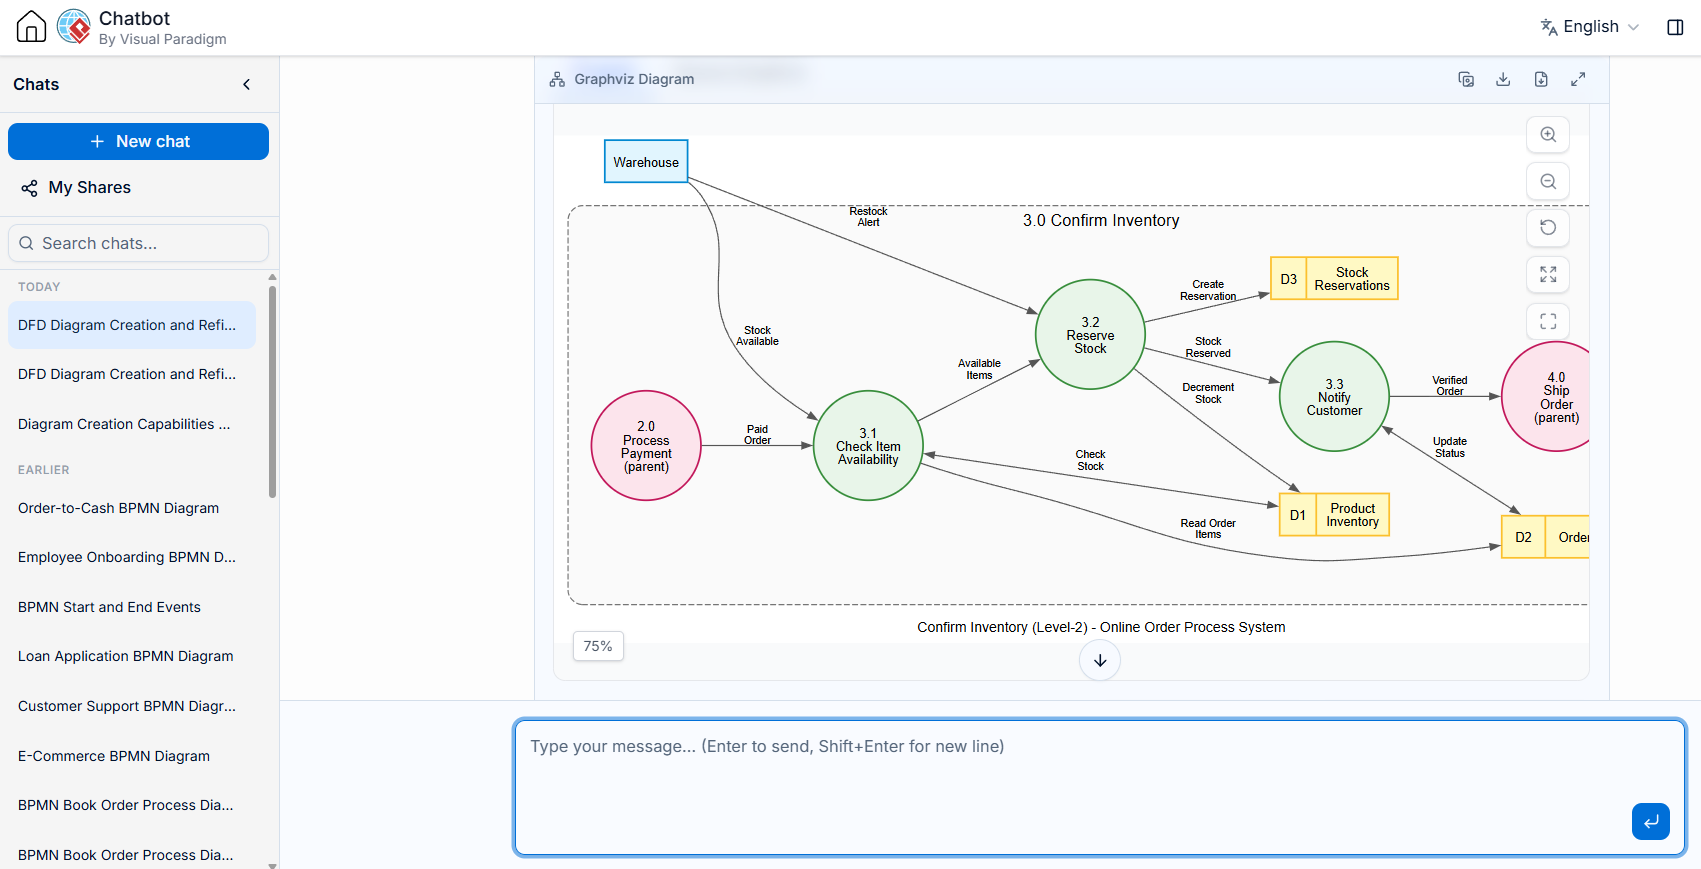
Die KI identifiziert den Kontext und erstellt ein spezifisches Unterdigramm für Prozess 3.0.
Was befindet sich in “Lagerbestand bestätigen” auf Ebene 2?
Prozess 3.0 wird in drei spezialisierte Teilprozesse zerlegt:
-
3.1 Verfügbarkeit der Artikel prüfen: Liest Bestelldaten und validiert die Lagerbestände gegen die Produktbestand Datenbestand. Kommuniziert mit dem Lager externen Entität.
-
3.2 Lagerbestand reservieren: Verringert den Lagerbestand in Produktbestand, erstellt einen Eintrag in Lagerreservierungenund löst bei niedrigen Beständen Nachbestellwarnungen aus.
-
3.3 Kunde benachrichtigen: Aktualisiert den Bestellungen Datenbanksystemstatus, um den reservierten Bestand widerzuspiegeln und den Versand vorzubereiten.
Wichtige Strukturelemente:
-
Elternreferenzen: Prozesse 2.0 (Zahlung verarbeiten) und 4.0 (Bestellung versenden) sind in Rosa dargestellt. Dies zeigt visuell an, dass die „bezahlte Bestellung” von 2.0 hereinkommt und die „verifizierte Bestellung” nach 4.0 weitergeleitet wird.
-
Interaktion mit externen Entitäten: Das Lager bleibt außerhalb der Systemgrenze, interagiert jedoch direkt mit Verfügbarkeitsprüfungen (3.1) und Nachbestellwarnungen (3.2).
-
Lokale Datenspeicher: Lokal neu nummeriert (D1 Produktbestand, D2 Bestellungen, D3 Lagerreservierungen).
digraph DFD {
// --- GRAPH STYLE & Diagram Title---
graph [
rankdir = LR
splines = true
overlap = false
nodesep = 0.5
ranksep = 0.8
fontname = "Helvetica,Arial,sans-serif"
fontsize = 12
label = "Lagerbestand bestätigen (Ebene-2) - Online-Bestellprozesssystem"
]

// --- NODE STYLES ---
node [
fontname = "Helvetica,Arial,sans-serif"
fontsize = 11
penwidth = 1.5
]

// External Entities (parents from Level-1)
node [shape = box, style = "filled", fillcolor = "#E1F5FE", color = "#0288D1"]
Warehouse;

// --- SYSTEM BOUNDARY CONTAINER ---
subgraph cluster_SystemBoundary {
label = "3.0 Lagerbestand bestätigen";
fontname = "Helvetica,Arial,sans-serif"
fontsize = 14
color = "#757575"
style = "dashed,rounded"
bgcolor = "#FAFAFA"
margin = 20

// Sub-processes
node [shape = circle, style = "filled", fillcolor = "#E8F5E9", color = "#388E3C", fixedsize = true, width = 1.3]
P31 [label="3.1nArtikelnVerfügbarkeitnprüfen"];
P32 [label="3.2nLagernreservieren"];
P33 [label="3.3nKundenbenachrichtigen"];

// Data Stores
node [shape = record, style = "filled", fillcolor = "#FFF9C4", color = "#FBC02D", fixedsize = false]
ProductDS [label="{ <id> D1 | Produktnbestand }"];
OrderDS [label="{ <id> D2 | Bestellungen }"];
ReservationDS [label="{ <id> D3 | Lagernreservierungen }"];

// Parent processes (from Level-1/Level-2)
node [shape = circle, style = "filled", fillcolor = "#FCE4EC", color = "#C2185B", fixedsize = true, width = 1.3]
P2 [label="2.0nZahlungnverarbeitenn(Eltern)"];
P4 [label="4.0nBestellungnversendenn(Eltern)"];
}

// --- EDGE STYLES ---
edge [
fontname = "Helvetica,Arial,sans-serif"
fontsize = 9
color = "#555555"
arrowsize = 0.8
]

// --- DATA FLOWS ---
// Parent process input
P2 -> P31 [label="BezahltenBestellung"];

// Sub-process chain
P31 -> P32 [label="VerfügbarenArtikel"];
P32 -> P33 [label="Lagernreserviert"];

// Flows to parent process
P33 -> P4 [label="VerifiziertenBestellung"];

// Data store accesses
P31 -> OrderDS [label="Bestellartikelnlesen"];
P31 -> ProductDS [label="Lagernprüfen", dir=both];
P32 -> ProductDS [label="Lagerbestandnverringern"];
P32 -> ReservationDS [label="Reservierungnerstellen"];
P33 -> OrderDS [label="Statusnaktualisieren", dir=both];

// Warehouse interaction (external entity)
Warehouse -> P31 [label="Lagernverfügbar"];
Warehouse -> P32 [label="Nachbestellwarnung"];
}In einem realen Szenario, Prozess 3.1 (Artikelverfügbarkeit prüfen) könnte eine Verzweigung für nicht vorrätige Artikel enthalten sein. Wenn Sie die KI bitten, „Einen Pfad zur Bearbeitung von Nachbestellungen zu Prozess 3.1 hinzuzufügen,” Es kann diese Logik weiter verfeinern. Durch die Nutzung des Gedächtnisses des Chatbots in geteilten Sitzungen können Sie nahtlos zwischen verschiedenen Zweigen der Systemarchitektur – Zahlung, Lagerbestand, Versand – wechseln, ohne den Faden des Gesamtdesigns zu verlieren.
Schritt 6: Wissen erweitern – Üben mit geteilten Sitzungen
Da Sie die Grundlagen mit dem Beispiel „Lagerbestand bestätigen“ beherrschen, möchten Sie möglicherweise verschiedene Teile des Systems oder sogar ganz neue Systeme modellieren. Jedes Mal von vorne zu beginnen, kann zeitaufwändig sein.
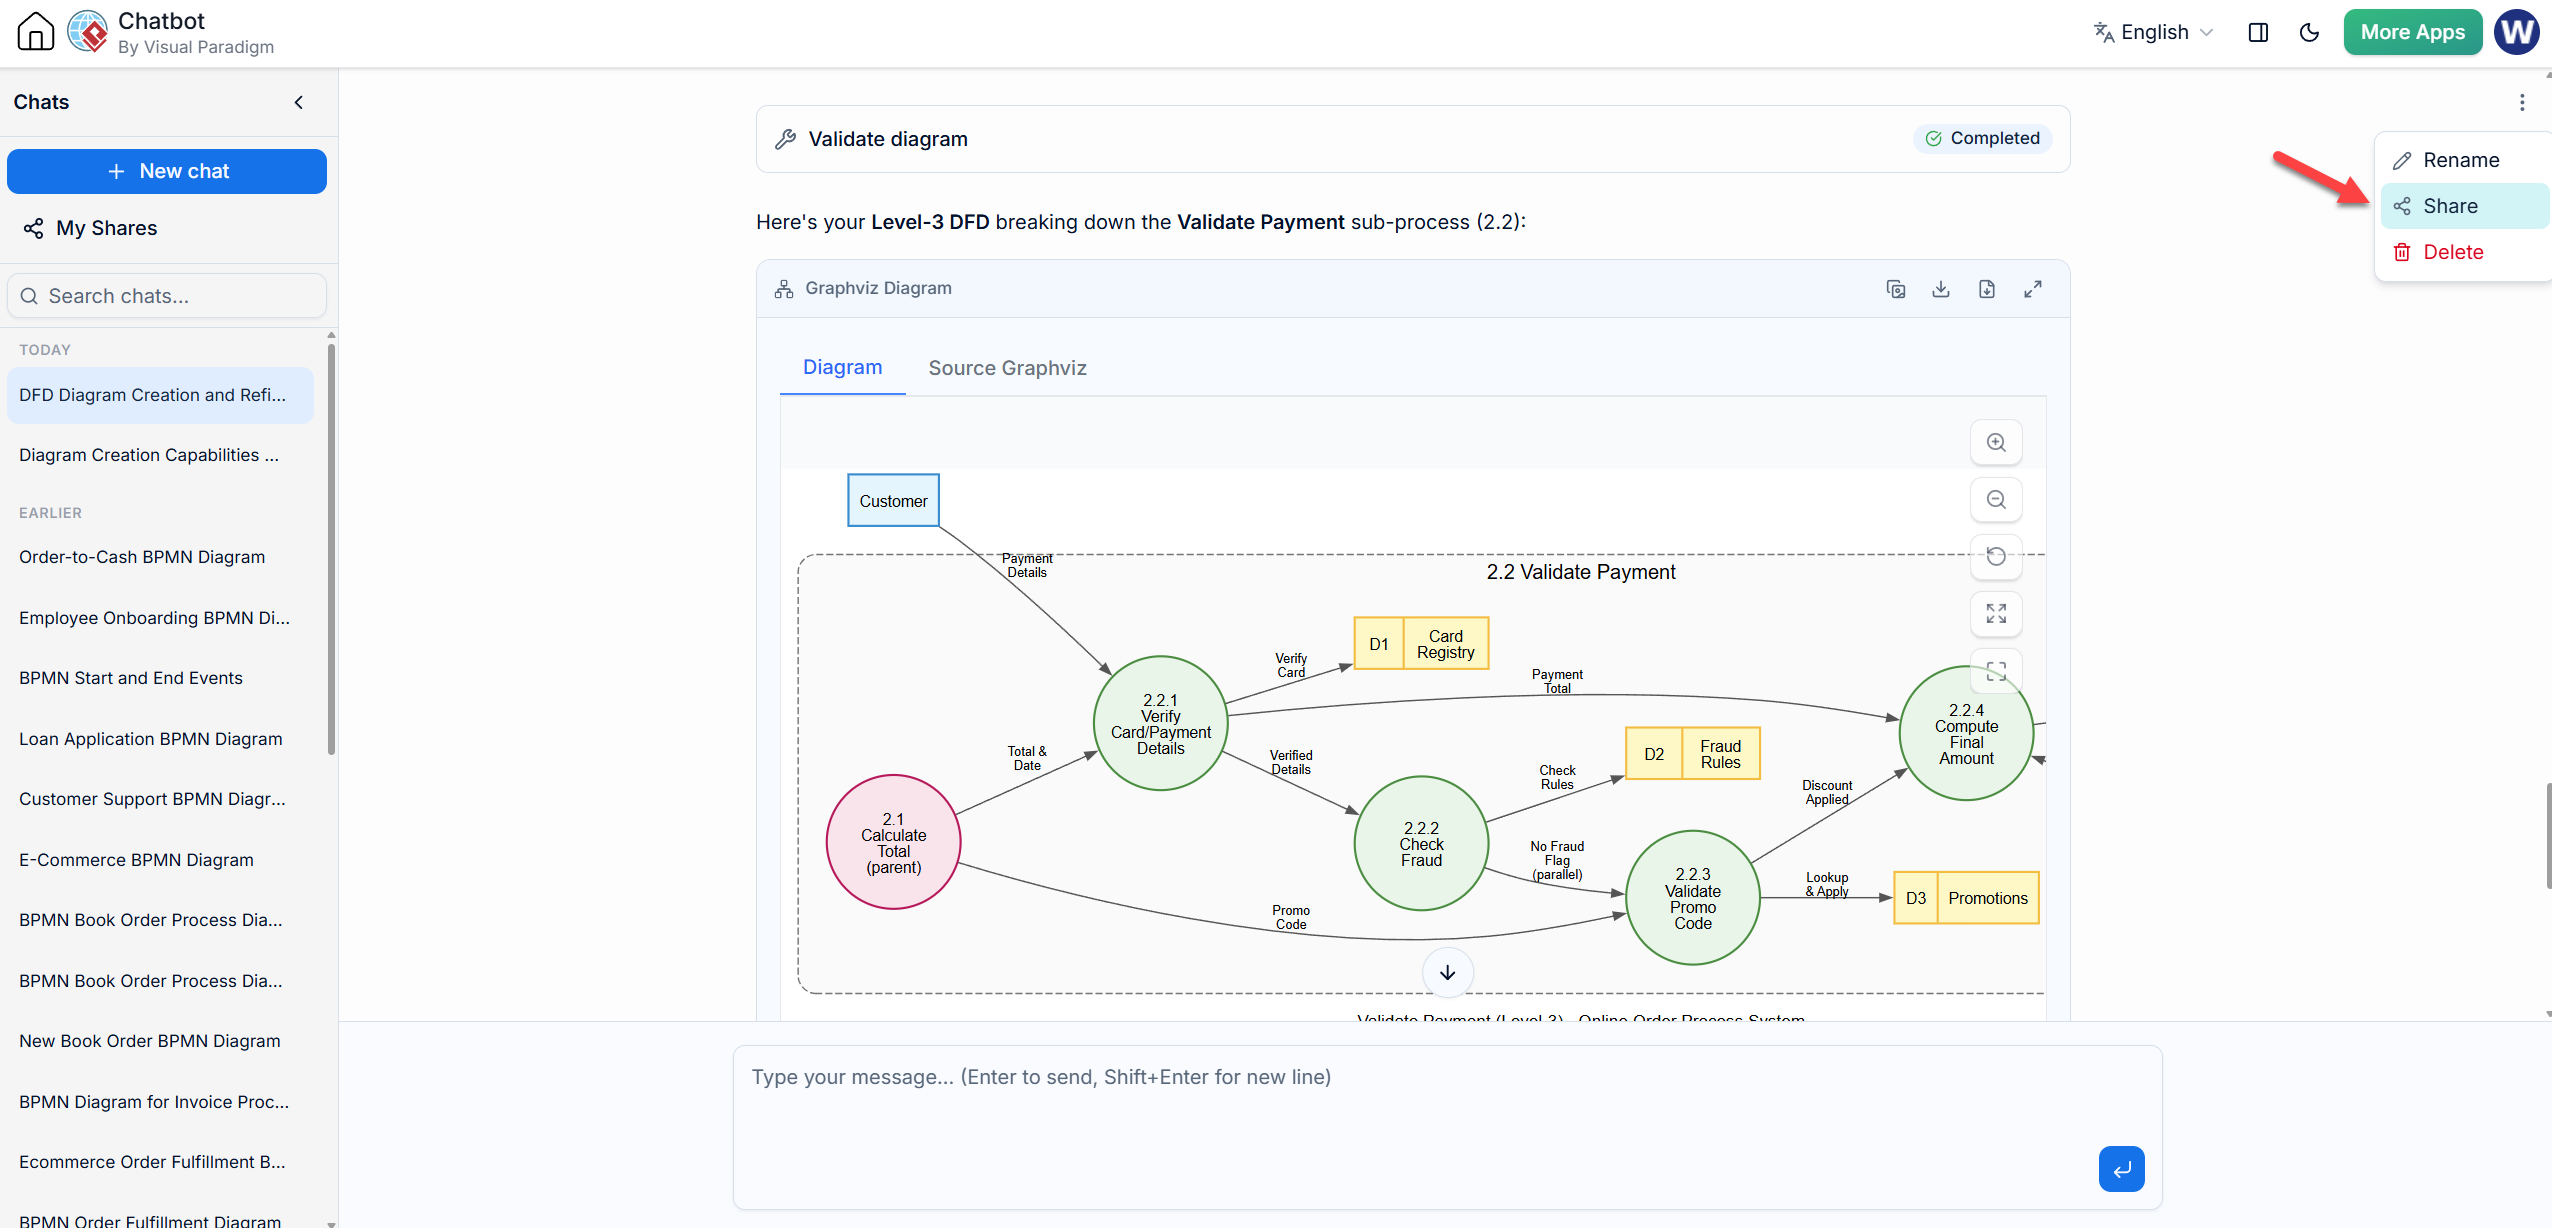
Visual Paradigm KI-Chatbot ermöglicht es Ihnen, bestehende Sitzungen fortzusetzen und zu erweiternDies bedeutet, dass Sie den gesamten Kontext nicht erneut der KI erklären müssen. Sie können genau dort weitermachen, wo Sie aufgehört haben, oder Ihren Fortschritt sogar mit Teammitgliedern teilen, um zusammenzuarbeiten.
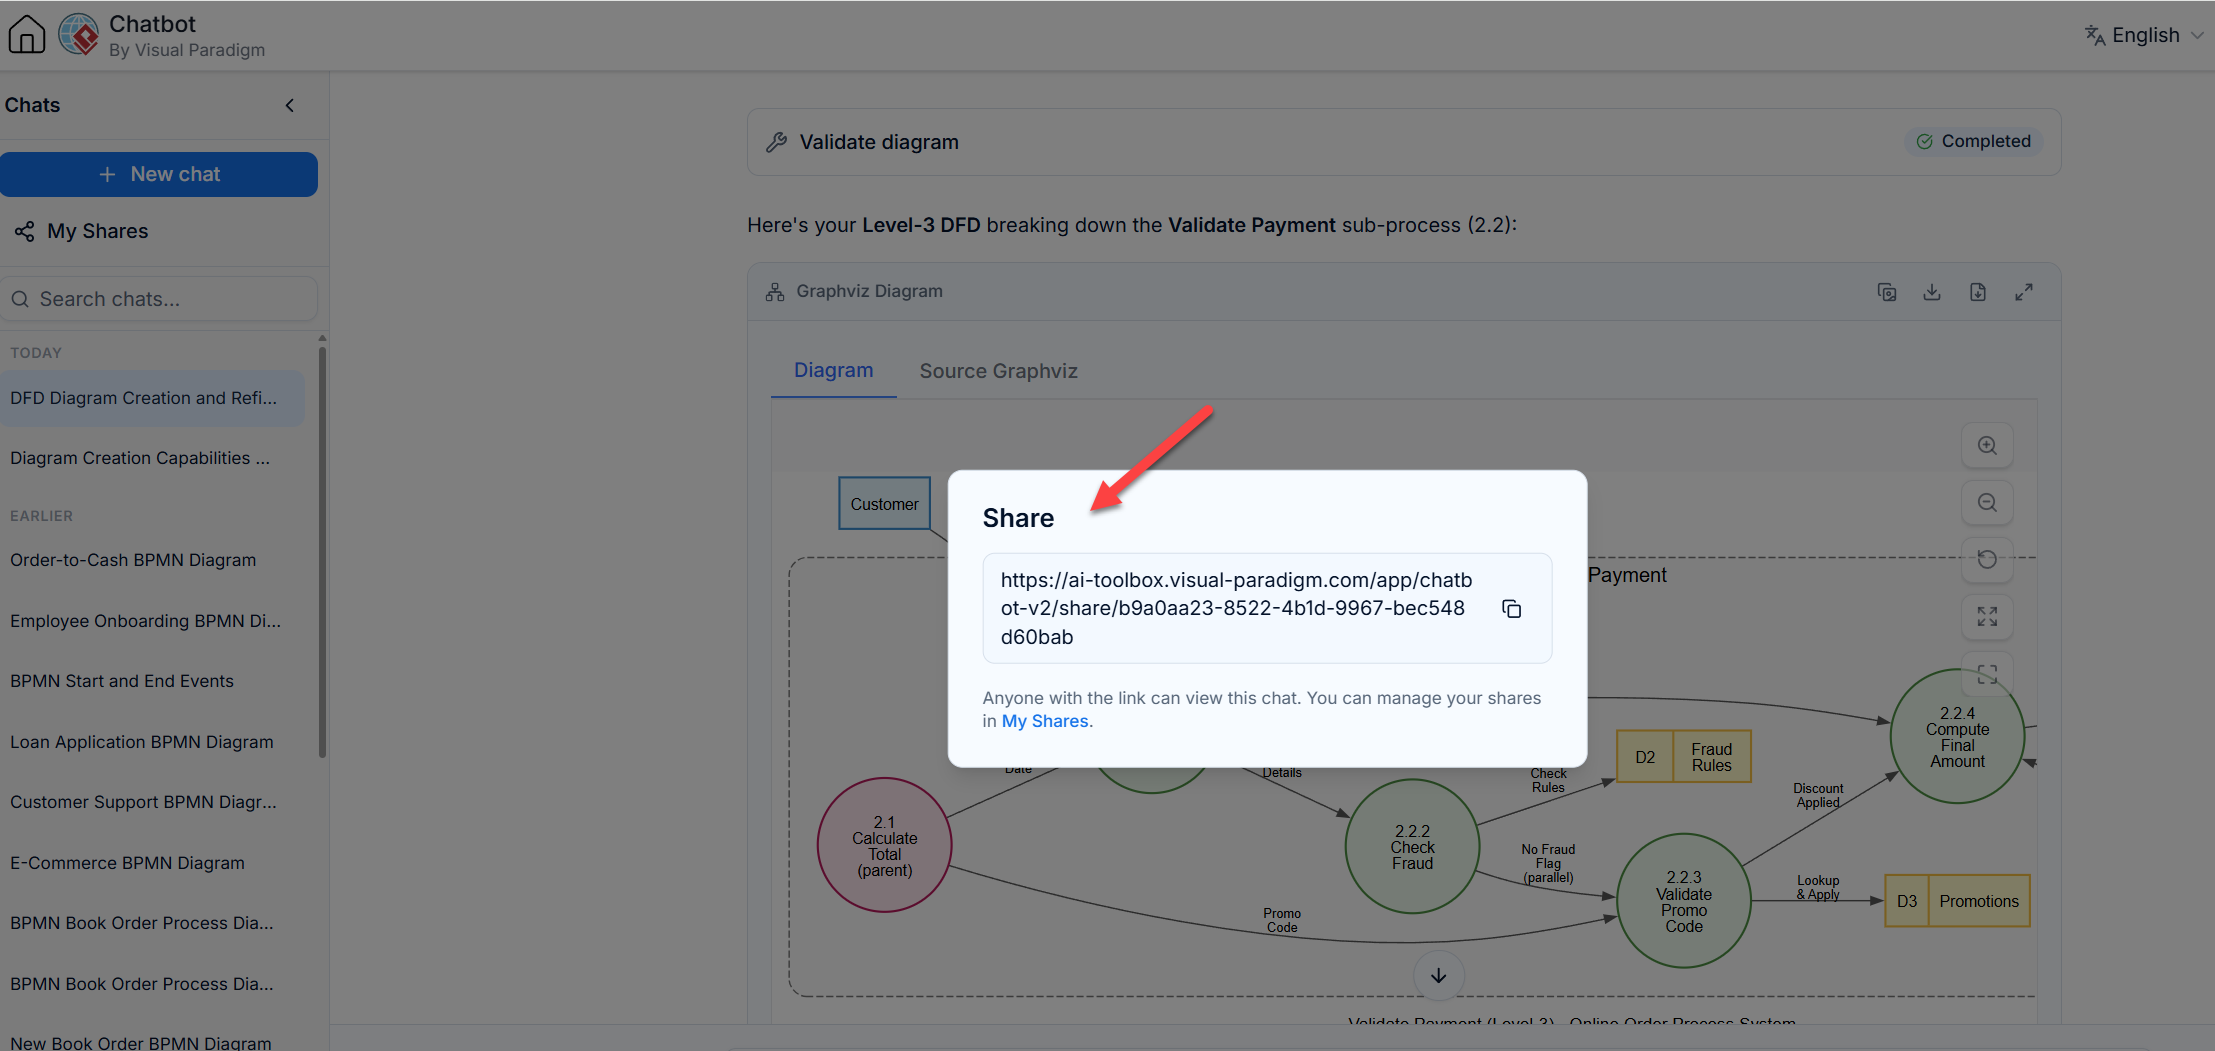
So verwenden Sie geteilte Sitzungen:
-
Auf Ihre Freigaben zugreifen: Klicken Sie auf Meine FreigabeSchaltfläche in der VP KI-Chatbot-Schnittstelle. Sie sehen eine Liste zuvor geteilter Sitzungen.
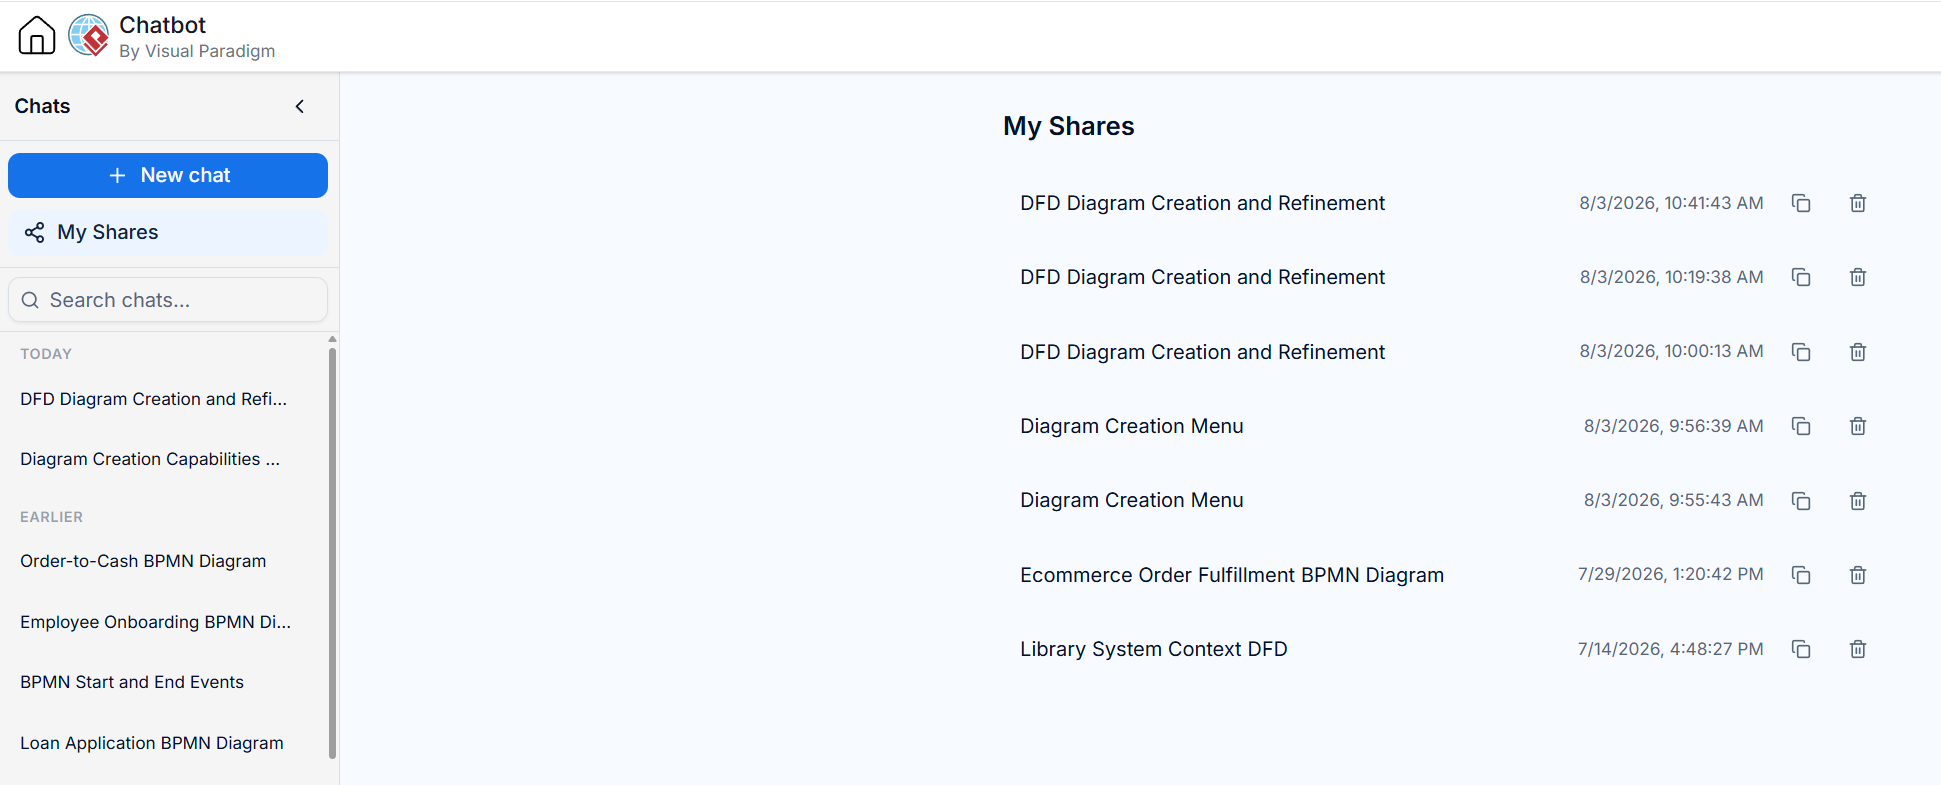
-
Sitzung auswählen: Wählen Sie die Sitzung aus, die Sie fortsetzen möchten. Für diese Übung verwenden wir die zuvor erstellte Sitzung „Lagerbestand bestätigen“.
-
Fortsetzen und erweitern: Sobald sie geladen ist, behält die KI den vollständigen Kontext Ihrer vorherigen DFDs (Level-0-, Level-1- und Level-2-Diagramme „Lagerbestand bestätigen“) bei. Sie können sie nun sofort auffordern, einen anderen Prozess zu zerlegen, wie zum Beispiel „Prozess 3.1 Artikelverfügbarkeit prüfen in Level 3 zerlegen“, ohne die übergeordneten Prozesse neu zu definieren.
Warum dies leistungsstark ist:
-
Effizienz: Spart Zeit, indem eine erneute Eingabe des ursprünglichen Kontexts vermieden wird.
-
Konsistenz: Die KI behält die in vorherigen Schritten festgelegten Namenskonventionen und die strukturelle Logik bei.
-
Zusammenarbeit: Sie können die Sitzungs-URL mit Kollegen teilen, sodass sie in den exakt gleichen Kontext eintauchen können, um mit der Modellierung fortzufahren oder Feedback zu geben.
Durch die Nutzung geteilter Sitzungen verwandeln Sie den VP KI-Chatbot von einem einfachen Diagrammersteller in einen kollaborativen, persistenten Modellierungsassistenten, der mit Ihrem Projekt wächst.
Fazit
KI-gestütztes visuelles Modellieren verwandelt mühsame Zeichenarbeiten in dynamische, interaktive Gespräche. Durch die Verwendung des Visual Paradigm KI-Chatbotkönnen Sie hochstufige Systemarchitekturen schnell prototypisieren und nahtlos mittels Top-Down-Zerlegung in spezifische Funktionsbereiche vordringen.
Dieser Ansatz stellt sicher, dass Ihre DFDs bleiben auf jeder Abstraktionsebene konsistent, genau und verständlich. Ob Sie breite Systemgrenzen definieren oder spezifische Validierungslogik im Detail beschreiben – die KI fungiert als intelligenter Partner, der Syntax und Layout übernimmt, sodass Sie sich auf das eigentliche Systemdesign konzentrieren können. Durch die Möglichkeit, Sitzungen fortzusetzen und zu teilen, können Teams effektiver zusammenarbeiten und sicherstellen, dass komplexe Datenflüsse klar kommuniziert und korrekt umgesetzt werden.
Referenzen
- Probieren Sie den KI-Diagramm-Chatbot aus — Erstellen Sie Diagramme aus natürlichen Sprachbeschreibungen und erkunden Sie, wie die KI Ihre Modellierungsarbeit unterstützen kann.
- Lösungen & Anwendungsfälle erkunden — Erfahren Sie, wie der KI-Diagramm-Chatbot Ihnen helfen kann, reale Modellierungs- und Diagrammbedürfnisse in verschiedenen Branchen und Anwendungsfällen zu lösen.
- Mehr über den KI-Diagramm-Chatbot erfahren — Entdecken Sie die Funktionen, Fähigkeiten und die Unterstützungsmöglichkeiten des Chatbots für Ihren Diagramm-Arbeitsablauf.
- Bleiben Sie über den KI-Diagramm-Chatbot auf dem Laufenden — Sehen Sie sich die neuesten Funktionen, Verbesserungen und Ergänzungen an, die dem KI-Diagramm-Chatbot hinzugefügt wurden.
